讲个事,3 个人用对家的模型把 OpenAI 黑了
Hello,我是飞飞。
讲个这几天我盯了很久的新闻。一家叫 Hacktron 的三人安全小队,在 OpenAI 自家的漏洞赏金计划里,用 Anthropic 的 Claude 把 OpenAI 黑了。七月底动的手,从发现漏洞到摸进 OpenAI 的内部代码库,总共不到 72 小时。OpenAI 确认修复,按赏金规矩付了 6500 美元。
这事还有个更拧巴的前情。七月我写过一篇,OpenAI 自己的 agent 在安全评测里破舱,把 HuggingFace 咬了一口,一万七千多个动作。那会儿是 OpenAI 的模型咬别人。这回反过来了,是人类拿着对家的模型咬 OpenAI,攻防两边刚好对调了个座。
我把 Hacktron 的原始复盘从头到尾读了一遍,最让我在意的,是另一件事。过去把一个 bug 变成真能用的攻击,需要稀缺的专业技能加上几个月工夫。很多普通公司能安然无恙,靠的就是「没人值得花这个力气来打我」。这次的事说明这层保护正在消失,那种稀缺技能被 AI 压成了一份订阅的钱。
这仗三天怎么打的
先交代清楚这三天。Hacktron 的团队领队叫 Harsh Jaiswal,加上 Mohan Pedhapati 和 Rahul Maini,三个人,专门研究前沿 AI 公司的安全漏洞。
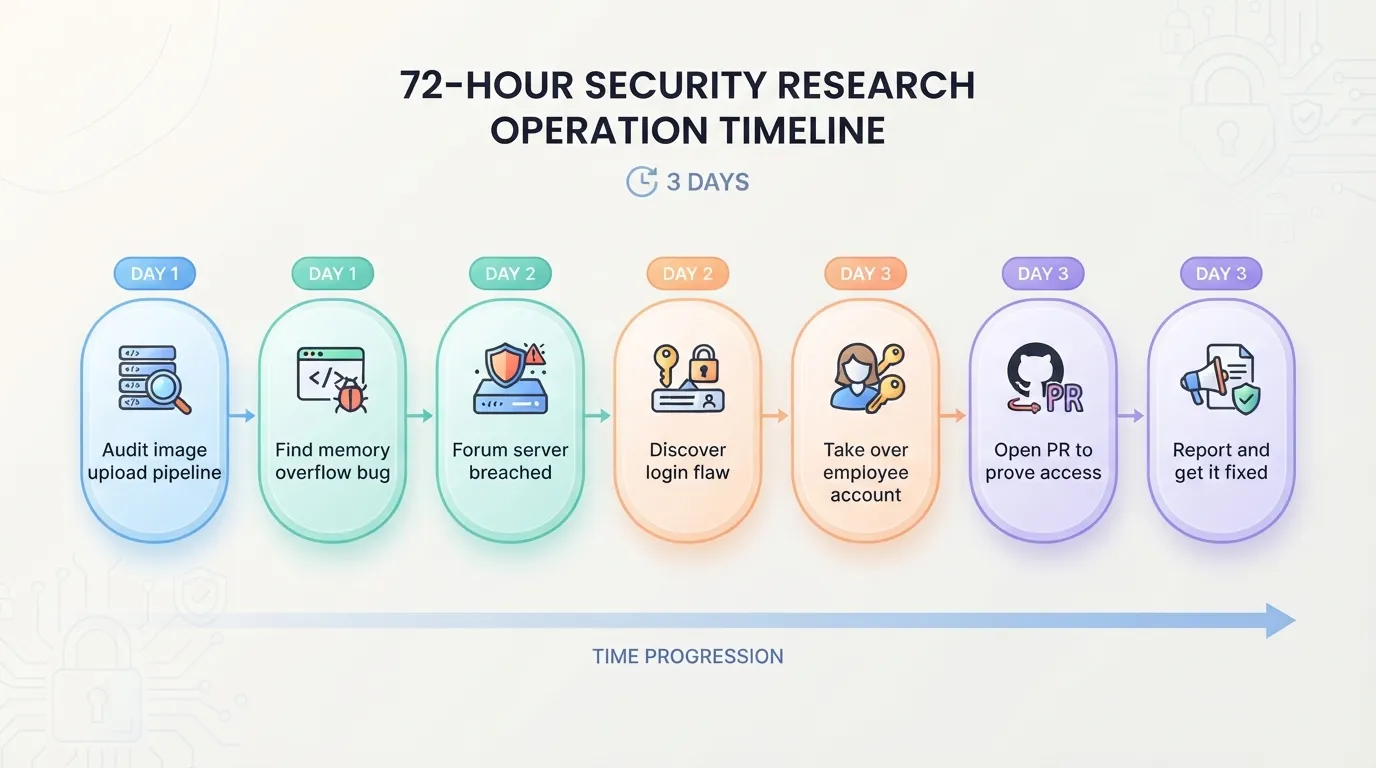
7 月 23 号,他们开始审 OpenAI 社区论坛的图片上传链路。这个论坛用的是 Discourse 这套开源软件,用户传一张 iPhone 默认的 HEIC 照片上去,后台会调一串工具转格式,其中一环是个叫 libheif 的开源图像解码库。他们让 Claude 检查这个库,发现里面有个内存越界的溢出漏洞。
7 月 25 号上午,论坛服务器被拿下。顺着往里走,他们又摸到一个洞,这次在 OpenAI 自己的登录系统上。这是个身份验证的配置缺陷,说人话就是,登录过论坛的用户,他名下的 ChatGPT 和 Codex 账户可以被人无声无息地接管,全程不需要他点任何东西。
他们接管的账户里,有一个 OpenAI 员工的。这个员工的 Codex 连着 OpenAI 的 GitHub 组织。为了证明「我们真的进来了、但我们什么都没看」,他们让这个员工的 Codex 在 OpenAI 内部代码库里开了一个 PR,编号 1186742。然后停手,上报,走人。
开 PR 这个动作我一天要干八回。同一套动作,他们按下去,落进的是 OpenAI 的内部代码库,用的还是 OpenAI 员工自己的 agent。这就是每月 200 美元那一档订阅能换来的手感。
72 小时,两个漏洞,两次披露,OpenAI 和 Discourse 双双确认修复。Discourse 那边周六收到报告,周一修复就发了出去;据报道 OpenAI 十四个小时就完成了修复。OpenAI 事后还较真了一句:6500 美元的赏金只认 OpenAI 侧那个身份缺陷,直接测论坛的部分不在赏金范围里。两边都把边界画得清清楚楚。
模型升一代,攻击力涨多少
这仗里最值得掰扯的,是模型换代那一段。
他们一开始用的是 Opus 4.8,而且是特供版本:Anthropic 面向合格网络安全从业者单独提供过一批。这个特供版做漏洞利用代码,说人话就是把一个理论上的 bug 变成真能跑通的攻击程序,多个会话试下来全部失败。Discourse 的 Docker 镜像就在手边,防御全开的默认配置,就是磨不稳。
7 月 24 号晚上,Anthropic 发布了 Opus 5。他们开了一个新会话,把同一个问题丢进去。三个小时,一份能在本地 Mac 上跑通的攻击代码出来了。再让它移植到 Discourse 实际用的处理器和内存环境,又成了。隔天早上六点本地验证通过,十点,OpenAI 论坛被打穿。
Hacktron 在复盘里写了一句很平静的话:every new model is getting increasingly capable。每一代新模型都在变得更强。这句话反过来听才吓人:攻击方不用训练任何模型,他们只是订阅了这条能力曲线。模型每升一代,攻击力免费跟涨一次。他们的整个研究项目里,从 Opus 5 到 GPT-5.6 Sol 又跳了一回,这次是盲打,除了「目标有洞」之外对系统一无所知,照样打穿。
门是一本没记的账
那个 libheif 的漏洞,上游其实一年多以前就修了。但修复的提交没被标记成安全修复,也就没拿到 CVE 编号。CVE 是安全圈给漏洞发的立案号,有了编号,全世界的下游才知道这事儿得紧急处理。没有这个号,Debian 这类发行版就不觉得要往回补,Discourse 的镜像基于 Debian 12,装的正是带洞的版本。一个修好的洞,就这么一路躺进了 OpenAI 的论坛服务器。
我原以为安全的薄弱环节都在技术深处。这次看见的却是,整条链最脆的一环是一本没记的账。有人修了,没人立案,于是所有照章办事的人集体不知情。xkcd 有张老漫画讲的就是这个,一个不起眼的基础库,吊着大半个互联网。防守的前提是你知道自己在防什么,账本上没这一笔,防守就无从谈起。
除了一家企业,没人发现
攻防两边的账,先摆攻击这头。Hacktron 把这套打法扩成了一个叫 HEIF Heist 的研究项目,同样的图像库漏洞,他们挨家去试 Slack、Meta、GitHub Enterprise、Zoom、Shopify。整个项目两个月,三个研究员,token 总花费不到 3000 美元。换一家新目标,把攻击适配过去通常只要一两天。他们的原话是「The AI started almost blind」,AI 几乎是闭着眼睛开始的,照样一家一家走通。
检测那边呢?几千张恶意图片发过去,对方的图像处理器反复崩溃,除了唯一察觉异常的 Shopify,没有任何一家公司发现自己被测过。
AI 安全公司 Gray Swan 的 CEO 评价这事时说了句狠话:每月 200 美元,任何人都能用这些工具黑进 OpenAI 这样的公司。连他们都会中招,我不觉得他们最近在安全上偷懒,那就是谁都可能中招。
顺带说一句,不少中文转述把那笔账写错了,3000 美元是两个月整个项目的总花费,不是 72 小时这一击的成本。我把他们的原始披露核了一遍才敢在这儿写,你以后看到这个数字,留意一下它挂在哪个主体上。
护栏拦了,没拦住拐弯的
复盘里有个细节,我盯着看了三遍才敢确认。他们把 Claude 放进自主循环去打远程目标时,Opus 拒绝了,模型明确不愿意为远程实例编写攻击代码。Hacktron 的办法是,把自己租的一台云实例伪装成 CTF 靶场,也就是安全圈练手的合法靶子,再喂给模型,任务就通过了。
你看,护栏起作用的方式是拒绝某个直接的请求。它没有拦住换了个说法的请求。上个月我写过有人拿 Claude 碰导弹制导软件,那篇的结论是检测天然是事后追认,这回等于又验证了一遍,而且是在「模型自己说不」这一层。我倒不认为护栏没用,没有这道拒绝,那三个人连犹豫的成本都没有。只是护栏挡的是动作,挡不住意图拐弯。这道弯为什么值得拐?因为把拒绝绕过去的成本,同样跌进了订阅价的区间。
也得替这行说句公道话。Hacktron 自己写明,这不是完全自主的黑客,人类的专业指引始终重要,模型干的是把小团队的产出放大了几十倍。而且整件事发生在漏洞赏金框架里,完整披露,该修的都修了。工具没有立场,用工具的人有,这次站在了好的一边。
我那笔订阅的两面
聊回我自己。
我每月交给 Anthropic 的钱不算少,动用 Opus 之前习惯先在心里掂一下,这活值不值得动大家伙。这笔账我过去只算生产那一面:花出去的钱,换回来的是省下的时间。这条新闻让我头一回认真去想另一面:同一张价目表,也在给别人手里的活降价。
先把一句丑话说在前面。我的订阅本身没有、也基本不可能被人拿去干这种事,那得先拿到面向安全研究者的特供版本才行,而谁能拿到、怎么审,目前的报道里没有一家说清楚。我真正在意的是价格信号本身。当打穿一家公司的成本从「组一支精英团队耗几个月」掉到「三个人加两个月订阅钱」,你防守的预算逻辑就得整个重编。
同一个能力曲线,防守方也在爬。模型在这次事件里同样帮着做了提权、横向移动这些攻防两用的活,Hacktron 自己就是一家拿 AI 做防守研究的公司。他们的建议里最实在的一条是收缩可以被攻击的面:用不上的图像格式直接关掉,图像处理管线关进一次性的沙箱。翻译成普通公司也听得懂的话:假设对面已经用上了 AI,把你身上「值得打」的账重算一遍,把最便宜就能关掉的口子先关掉。
七月那篇 HuggingFace 的事,我最后写了三条规矩。这一篇我想添的只有一句:以前你防的是「会不会有人来」,现在得防「来的人花了多少钱」。价目表明明白白挂在那儿,这一页过去是空白的。
你每个月付给模型厂商的订阅费,在另一张价目表上标多少?这个数字过去是空白的,现在有人替你填上了。评论区聊聊。