Sonnet 5.5 单价便宜一半,账单贵了 92%
Hello,我是飞飞。
同一家的两个模型,价格表上一个比另一个便宜一半,结账的时候,便宜那个反而贵了 92%。
这是 Arena.ai 那张 Agent 榜 10 月 2 日快照上的真实数字。两周前那篇讲的是开源模型按参数挑反了,这次是同门两档之间的倒挂。
我这辈子干的是写字吃饭的活。这一行有个特别朴素的计价法,稿费按字数结。同样一件事,有人两千字写完,有人八千字写完,读者拿到的故事一模一样,后者的稿费是前者的四倍。今天这个模型的事,我第一次觉得,该拿我这行的算法去看它。
同一家两档,账单反着来
Anthropic 的 Claude Sonnet 5.5,在这张 Agent 榜上排第 3,净改进 +12.52%。排第 2 的是它自家大哥 Opus 5.5(High 档),+13.82%。
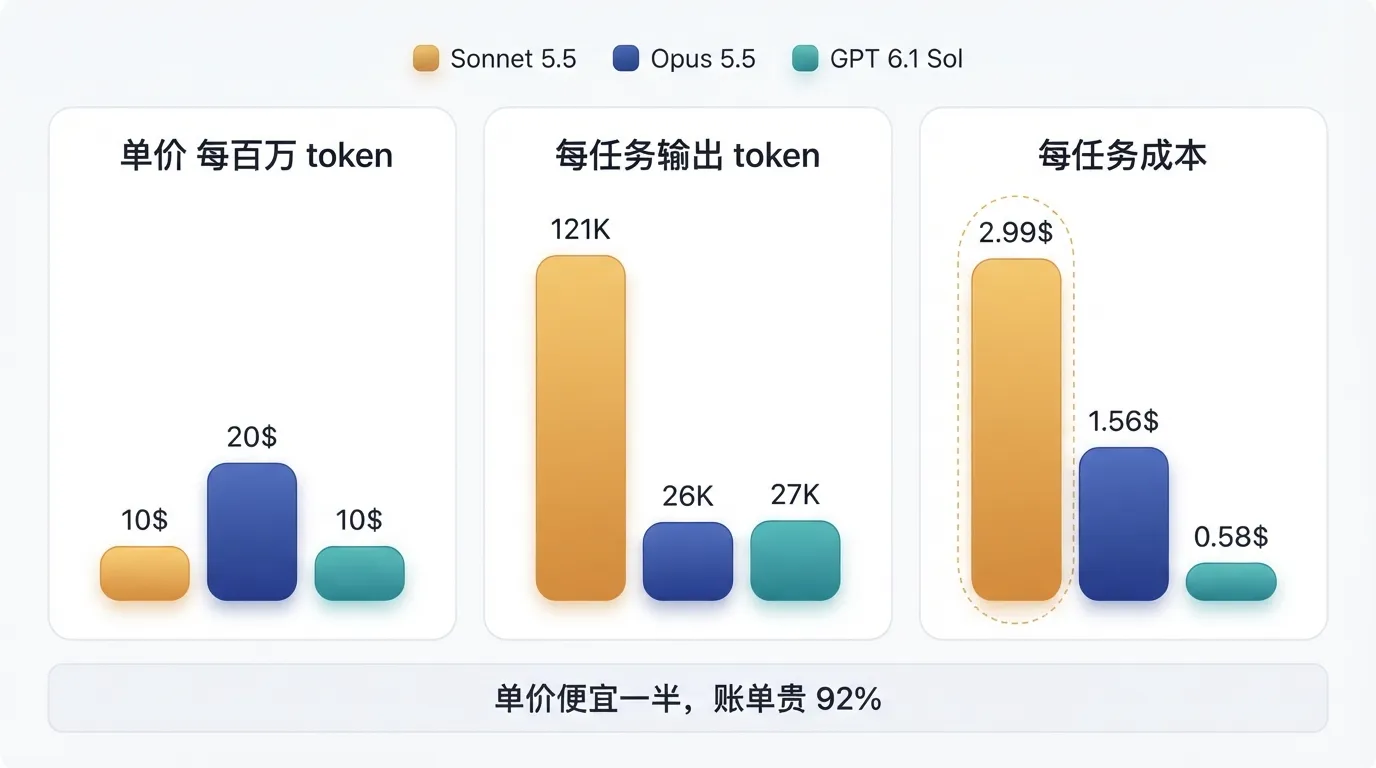
名次差一位,账单差多少?Sonnet 5.5 每任务 2.99 美元,Opus 5.5 每任务 1.56 美元。Sonnet 5.5 贵了 92%。
这张榜当天统计了 215.8 万场真实会话,51 个模型在列。Arena 还给每条数据配了一张 Pareto 前沿图。纵轴是分数,横轴是每任务成本,划出「再多花一分钱也买不到更好表现」的那条边界。前沿上只有 8 个模型,Fable 5.1、Opus 5.5、GPT 6.1 Sol、Deepseek V4.1 Flash、MiMo V2.6 Pro、GPT 6 Luna、MiMo V2.6 Flash、MiMo V2.5 Pro。
Sonnet 5.5 不在这 8 个里面。
贵在哪,不在价签在话多
单价这一头,Sonnet 5.5 是真的便宜。
它每百万 token 输入 2 美元、输出 10 美元;Opus 5.5 是输入 4 美元、输出 20 美元。整整便宜一半,价格表没说谎。
那多出来的钱花在哪了?花在它每任务说了多少话上。
同一张榜给了这个数:Sonnet 5.5 每任务输出 121.3K token,Opus 5.5 只有 26K。4.67 倍。
这就是稿费那条算法的意思。单价是每千字多少钱,token 是它交了多少字。千字单价便宜一半,交稿字数多四倍多,结出来的账当然更贵。
Artificial Analysis 那边独立测出了同方向的数,而且更极端。max 档下每任务约 193k 输出 token,是他们测过的所有模型里最高的。比 Opus 5.5 高约 60%,是 GPT-6 Astra 的约 7 倍。他们的原话是,Sonnet 5.5 的定价跟上一代 Sonnet 5 完全相同,每任务成本却高了约 50%。他们也判定,它落在自己那张前沿图外面。
两家机构用两套完全不同的任务集,撞出了同一个结论。
同单价的两个模型
要看清单价和 token 各占多少,最干净的一组对照,是拿它跟 OpenAI 的 GPT 6.1 Sol 比。
这两个模型的单价一模一样,都是输入 2 美元、输出 10 美元。
账面结果呢?Sonnet 5.5 每任务 2.99 美元,Sol 每任务 0.58 美元。差 5.15 倍。而它们的每任务输出 token 是 121.3K 对 27.4K,差 4.43 倍。
单价这个变量被彻底控住了,剩下的唯一差别,就是它每完成一件活要说多少话。Sol 排第 5,Arena 官方发这条数据时自己写了:它比 Sonnet 5.5 便宜 80%,分数只差 1.29 个点。
先说清我按什么付钱
上面那串美元数字,落到我身上得换个算法。
我自己主力走的是 Claude Max 订阅,按月交固定的一笔钱,不按 token 计费。所以「每任务 2.99 美元」这件事,兑现不到我的月费上。
它兑现成另一个东西:额度。同样的月费,一个模型每任务烧掉的话多四倍,我一天能跑的活就少一截。省下来的东西不落在账单上,落在能多跑几件事上。
这笔账我 7 月真算过。那时候我把写文章这条流水线全用 Sonnet 跑,六个 skill 跑完一篇,一个月吃掉我 19% 的额度。后来按任务分档,写作和润色留在 Sonnet,搜料、配图、分发全压到更便宜那档,直接降到 8% 到 9%。省下的那一半多,跟今天是同一个道理:别让贵档干便宜活。
所以同一个「每任务 2.99 美元」,按月付的人和按量付的人,读出来的意思不一样。
官方自己承认了这件事
Arena 那份方法论里,官方自己把这事写出来了。原话是:我们发现有些模型实际上更贵,尽管它纸面上的定价更便宜。
原因有两个。一个是模型的行为,比如每轮做的步数更多。另一个是被模型诱导出来的用户行为,比如要更多轮才满意。
两个机制里,藏得深的那个是后一个。
话多这一层好理解,它自己啰嗦。更狠的是另一层:你多绕的那几轮,也算在它头上。 它把你带得多问了几句、多改了两遍,这些轮次的成本照样记进它的账。
按这个口径,贵的那部分里也有我自己的一份。这个算法我认,那几轮确实是我为了拿到想要的结果才发出去的。
多说的话买到了容错
有件事得替它说清楚:Sonnet 5.5 多说的那些话,不全是水。
这张榜有五个信号列。其中一个是 bash 恢复率,意思是它敲错一条命令之后,几轮之内能自己绕回来。Sonnet 5.5 这一项是 15.05%,全场最高。Fable 5.1 是 12.39%,GPT 6 Astra 只有 5.34%。
把每一步都摊开写下来,出错的时候就更容易被你自己一眼看出来。这个动作本身有价值。
那分数呢?Opus 5.5 是 +13.82% 带 ±2.17% 的误差棒,Sonnet 5.5 是 +12.52% 带 ±3.09%。两个数差 1.30 个百分点,合起来的误差是 3.78。严格讲,这张表分不出这俩谁更聪明。
分数分不出来,账单分得出来。 它多付的那 92%,买到的是更抗错,跟「更聪明」没什么关系。而且它的样本量 5,219 场,是前五名里偏少的那个,所以误差棒最宽的一项到了 ±13.05%。
这榜的账,我能照用吗
榜单上的名次和账单,本来就是两套账。
最要紧的一处是成本口径,它的每任务成本只统计每个会话的前三个任务。官方给的理由是长会话的上下文会累积,后段任务天然更贵。一刀切平均,会冤枉那些更粘人的强模型。可你看它自己的数据,最近这批会话里 32% 最后一轮至少带 128k 输入 token,8% 至少 1M。真实使用里,长会话是常态,而榜单主动砍掉的正是后段那部分成本。
我自己就是个长跑用户。有回贪快,让一个会话连撑了六个钟头。前半程还好,到后半程它开始重复生成我早写过的函数,还顺手把旧逻辑改错。
那次翻车让我记住的不是它错在哪,是它错在第几个钟头。这种活的价值和风险都堆在后半程。而后半程恰恰被这个榜切掉了,出问题的那些轮次,一个都不在它的统计范围里。
越是我这种长跑用法,它那张表离我的真实账单就越远。那笔多花掉的钱,没人替我记过。
还有一处是范围限定,这一版只评主模型。官方原话是,这一版只评估决定调用哪个工具的那个主模型,壳子等其他组件的排名「即将推出」。而我的成本结构里,壳子和那十几个 skill 恰恰是主体。它没算。
剩下那处是口径本身会飘,两家第三方还会打架。同一个 Sonnet 5.5,我看到的数是这几个:
| 来源 | 每任务成本 | 口径 |
|---|---|---|
| 我手上那份摘要 | $2.74 | 转述,未核原文 |
| Arena 榜实测 | $2.99 | 最近 14 天中位,滚动更新 |
| 一家媒体早几天的快照 | 约 $2.78 | 同口径,窗口不同 |
| Artificial Analysis | $7.60 | 自家的指数任务集 |
四个数,四个口径。别把它们并排当同一个东西。
我 7 月那本账要重判
7 月那篇的结尾我留过一句话:标价便宜四成,不代表账单降四成。别信 sticker price,拿自己真实的活跑一批,看月底实际扣了多少才算数。
方向我到现在也认。但我当时把机制写偏了。我说膨胀出在输入侧,Sonnet 5 换了分词器,同样一段字多吃 1.0 到 1.35 倍 token。
今天这个 4.67 倍出在输出侧,跟分词器没关系。两处不是一个地方,量级也差着三四倍。
那篇里还有一条比警告具体得多的建议,更该重判。我当时写的是,质量要求没那么顶、但一天要跑几十上百次的高频活,是 Sonnet 5 最该接手的地方。
这条今天正面撞上了这组数据。Sonnet 这一档每任务比自家 Opus 贵 92%,把它往高频活上派,恰好是最费额度的那种派法。当年我按单价算,觉得降档最划算;按每任务成本算,方向反了。
我这本账的尺子用了大半年,是三样相乘:这活错一点的代价,一天跑多少次,单价。末项得换掉。不再问「它多少钱一百万 token」,改问「它跑完我这件活,实际要掏多少」。前两项不动,代价和频率还是老样子。
你以后再看这类榜,按四个动作走一遍就行。先看单价栏填没填,Sonnet 5.5 那一栏在 Arena 上是空的,是 Artificial Analysis 才给出 2 和 10。再看每任务成本,那是真正会记到你账上的数。然后看每任务输出 token,那一步解释了钱花在哪。最后翻样本量和误差棒,一个 ±13% 的信号,读的时候得留余地。
四个动作做完,名次和账单才算分开。
我还没在 Arena 上跑过自己的活。这篇的一手,只有那 19% 到 8% 的一条旧账。等我把流水线里几个 skill 换成 Sonnet 5.5 跑一轮,回来跟你报真实扣了多少。
你现在手上最费额度的那条流水线,是咬牙用着最贵那档,还是早就分了档?评论区报一下它大概干什么、一天跑几次,我帮你看看有没有能挪的。