DeepSeek 搜索每千次 5 元,别按文章数算
Hello,我是飞飞。
DeepSeek 把搜索接口开放了,每千次成功且有结果的请求 5 元。你要是也让 AI 搜资料,这个价格很容易顺手理解成“查一千篇文章,五块钱”。可它按请求计费,一篇稿子可能搜几次,再抓几页正文,数量得另算。
我这条写稿流程最需要的,是少漏原文里的限定。这次就拿“11 月起收费”来对照:谁的调用开始收费,支撑这句话的正文有没有拿到,一次核对要算几次请求。
先交代范围:本篇核了官方指南和接口说明,对照现有资料流程。我没有调用新接口,也没有测搜索质量、抓取成功率。这些不能用文档示例顶上。
先把五块钱拆开
官方指南把 Search 和 Fetch 分成两个接口。前者按搜索词找网页,返回结果列表;后者拿一个网址,抓回这页的 Markdown 正文。
它们各按每千次成功请求 5 元计费。换算成单次,都是半分钱。Search 还要求结果列表非空,Fetch 要返回正文才计费。失败、搜索无结果或超时,文档写明不收这次的钱。
这里的单位是请求次数。搜索返回五条还是五十条,不改变单次搜索价格。你要是把五十条结果逐页再抓一遍,那些成功的 Fetch 请求就要另计。
做一笔预算算例,强调一下,这不是实测账单:
| 一组任务的设定 | 成功请求数 | 按文档单价计算 |
|---|---|---|
| 搜一次,直接用返回结果 | 1 次 Search | 0.005 元 |
| 搜一次,再分别抓三页 | 1 次 Search+3 次 Fetch | 0.02 元 |
| 重复上一组一千遍 | 1000 次 Search+3000 次 Fetch | 20 元 |
表里假定请求成功且有结果。模型读这些材料、继续推理或写稿的 token 费用,还得另算。这张表没有替你估模型账单。
不过,Search 也可以申请直接带正文。不能反过来照表机械接成“每条结果必须再抓一次”。正文已经够用的,没必要重复抓。费用能不能少,得先看实际返回了什么。
十一月是哪部分收费
指南还有一段容易漏看。通过 DeepSeek API,在 DeepSeek Harness、Claude Code、Codex 里使用的服务端 Search、Fetch 工具调用,目前未计费。这部分将于北京时间 11 月 1 日零时开始按次收费。
限定词别丢:通过 DeepSeek API。
这不表示所有 Claude Code、Codex 用户都要向 DeepSeek 付搜索费,也不能把它写成“新开放的独立搜索接口,月底前全部免费”。文档单列了接口价格,再说明上述工具调用的起收时间。
你可以按自己的接法对照:直接请求独立 Search、Fetch 接口,先看接口价格表;通过 DeepSeek API 在这些编码工具里触发服务端搜索,看十一月起收的那段说明。单说“我用 Codex”,还判断不了是否属于这里点名的调用。
这里也没承诺,只要用了 DeepSeek 模型,每个任务就必定搜索。一次纯代码修改究竟有没有触发工具,要看任务记录。把客户端名字当计费单位,和把文章数当请求数,一样会算错地方。
如果你就在这些工具里接 DeepSeek,要把这部分调用次数算进去。只盯模型的输入输出 token,可能会漏下一笔。至于任务实际触发几次工具,我手里没有你的调用记录,不能替你报数。
结果列表不等于原文
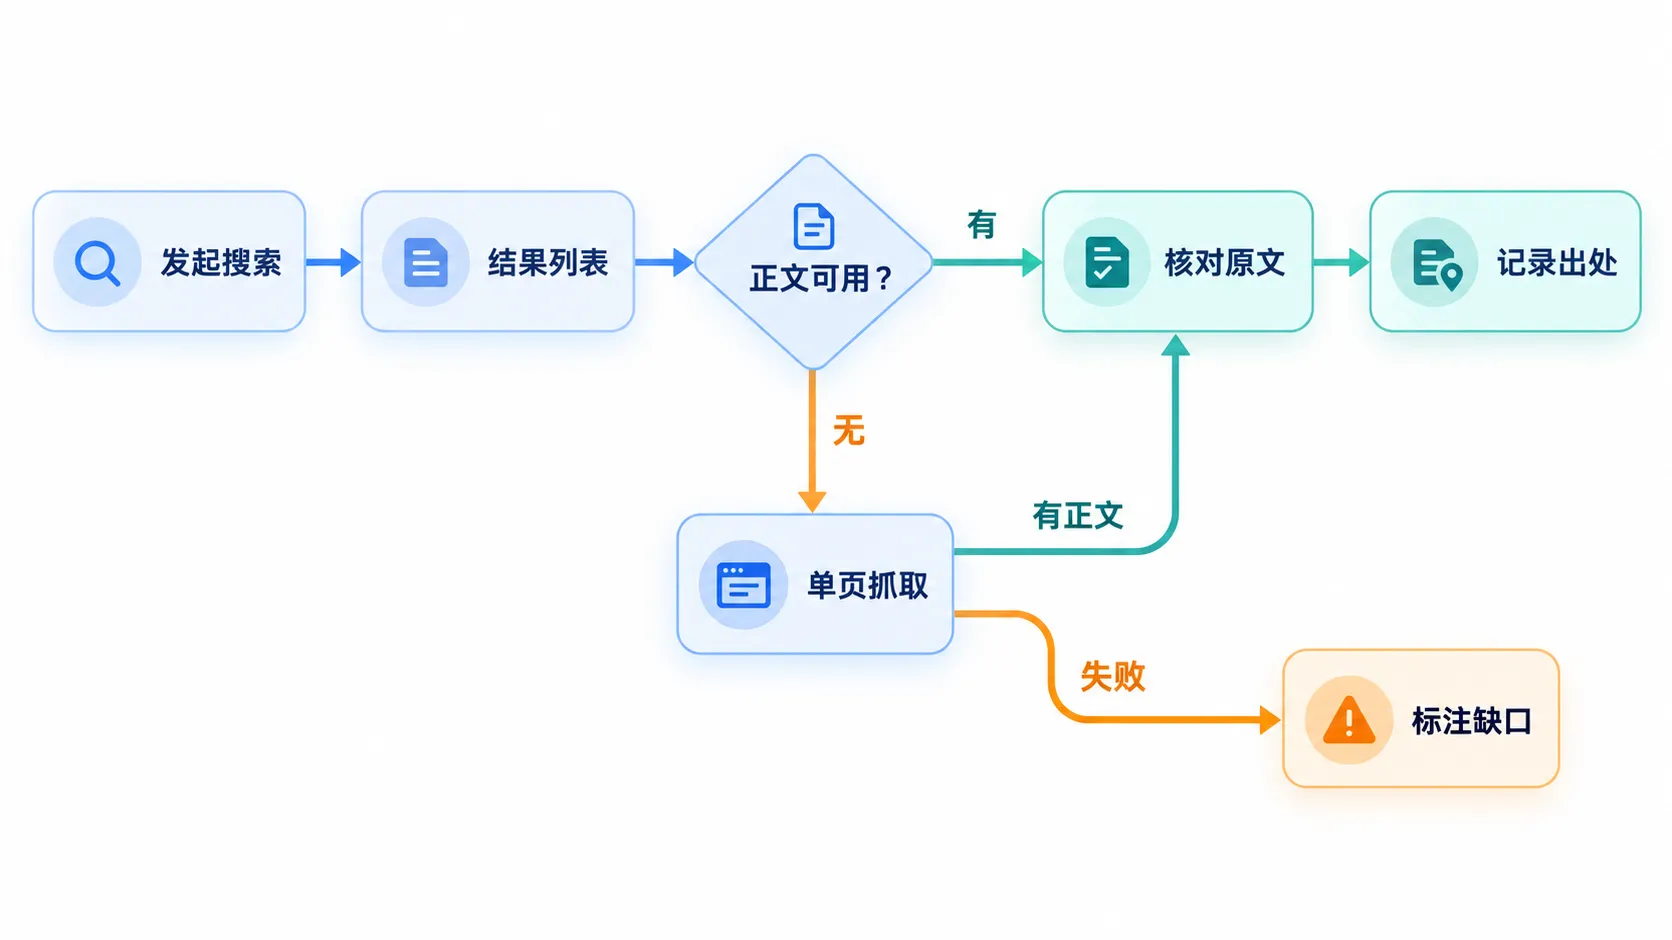
我现有的资料流程,本来就分搜索和读网页。先找到候选链接,再去看原文,保留来源,整理成写作材料。选题摘要只能指路,不能替原文下结论。
DeepSeek 的Search 接口说明也把返回内容分开了。有给前端展示的短摘要,有给模型阅读的长摘要,还有正文。你接入时最该看清的参数,是 need_content。
默认值是 false,这时正文就是空字符串。设成 true,才请求把正文带回来;但网页正文缺失时,仍然可能为空。
这意味着,你收到了一份带标题、网址、长摘要的结果,不能就宣布“原文抓到了”。要查的是正文那一栏,有没有能支撑关键说法的那段内容。
接口还会给排序分、权威性分和发布时间。它们有助于挑候选,不能代替核查。日期可能未知,评分也有自己的口径。我不会因为一页分高,就免掉对价格生效日、适用产品和例外条件的核对。
拿这次收费说明来说,可以先限定 DeepSeek 官方文档。链接少一点,重点是能不能把那段计费说明拿回来。正文里有没有“通过 DeepSeek API”,有没有“Server 端工具调用”,比摘要写了多长更要紧。
把这段原文跟摘要并排看,才知道摘要省掉了什么。要是手里只有一句“Claude Code 十一月搜索收费”,你连该查哪张账单都可能弄错。这是假设摘要丢掉限定时的风险,本篇没有测到某个搜索结果犯这种错。
我会要求搜资料这一步,把结论和支撑它的正文一起交回来。只附一个首页链接,后面的写手仍得再找一遍。如果有链接却没正文,先把这页列为缺口。
我以前卡在抓取这一段
六月写内容工厂搭法时,我记过一个坑:拉 AI 精选资讯的程序没带浏览器标识,被接口当成商业爬虫,返回了 403。当时排查了一圈,才确认问题在这里。
六月那次,403 至少告诉我没拿到东西。这次要防的,还有另一种情况:搜索请求成功,标题和摘要都有,正文却是空的。只看成功状态,缺口就容易被带进写稿环节。这是接入前要检查的风险,本篇没有跑出这类故障。
Fetch 接口接收单个网址,返回标题和正文。官方也留了限定:目标网站能否访问、允许怎么访问,都会影响结果。页面没有可提取正文、被站点策略拦住,都可能抓不到。
这跟六月那个坑不完全是一回事。六月是程序直接请求资讯接口;这次是让 DeepSeek 代抓网页。它可以减少我自己维护抓取逻辑的工作,却不能凭文档推出“所有站都能读”。
还有个错误码细节值得记:这里的 Fetch 返回 404,原因可能是网址不可用,也可能是被站点策略拦住,或没有可提取正文。它不能单独证明原文章不存在。搜索没匹配结果也可能正常返回空数组,这次不收费,却仍然没有替你找到证据。
我会把失败保留在资料结果里。找到链接但正文没拿到,就写清哪页缺正文。拿几段摘要拼成文章,再把状态标成“资料齐了”,后面的写手只会带着缺口往下跑。
过滤声明先当待验项
发布说明称,它会过滤 SEO 作弊、GEO 操纵和低质 AI 内容。说人话,就是希望搜索结果少被那些专门操纵排名和引用的内容占住。
这属于官方对搜索引擎的描述。我没有独立测试,不能接着写“现在搜到的都可信”。网站愿意把来源写清、正文便于机器读,也不能仅凭这些就判成操纵。
对我这条流程,有用的验收是把一个真实问题搜完,拿到原文,再核实一句重要的话。
你要做同样的检查,可以拿这次发布当题目:限定 DeepSeek 官方文档,查搜索收费单位和生效时间。把来源网址、搜索摘要、能支持结论的正文段落并排放下;拿不到正文就单列缺口。检查那句“11 月起收费”旁边,是否保留了 DeepSeek API 和服务端工具调用的适用范围。
这是下一步可做的对照方案,本篇没有跑出结果。我也先不替换整条资料链路。待验证的是能读回多少有用原文、有没有漏掉条件,以及一次完整核对用了多少成功请求。
五块钱的单位已经清楚了。真正决定我换不换的,是那半分钱买回来的内容,能不能让我少漏一句关键限定。
你最近留存的那条价格消息,只有摘要和链接,还是连适用范围的原文也存下来了?