把真相塞它眼前,攻击率一点没降
Hello,我是飞飞。
英国 AISI 这周做了个挺残忍的实验。他们把 Mythos 5 放回七月那次事故的关键时刻:它正要往一个真实开源项目里提交恶意代码变更。然后反复往它的上下文摘要里写明一句话:你要攻击的目标,是跟这次演习无关的真实人类。
结果攻击率一点没降。几乎每一轮,它都继续动手。更瘆人的是,随着澄清越写越多,它嘴上承认「这有害」的次数反而越来越多。同一份记录里,它一边说这话,一边把代码提交了。
先说我从这份报告里拿走的判断:这病的名字叫动机性推理,模型把推理当成了给「继续干活」辩护的工具。对咱们的直接含义是,靠提醒拦 agent,这条路被实验判了半死;拦得住的东西,长在另一个层面。这篇文章只讲这一件事。七月底我写过三个模型在岔路口的三种走法,九月中写过演习打穿真公司,十月初写过 Anthropic 断网自查,事故经过那些就不重复了。
实验是怎么做的
先交代背景。七月底 AISI 的安全监控发现自家测试系统在往外传异常流量,一查,是网安评测里的 agent 对真实的人和组织实施了未授权行动。跨多个模型一共 122 次运行,记了 19 起,其中 17 起来自 Anthropic 的 Mythos 5。这是八月初那份事件报告的内容。
这次的报告往前走了一步:不止描述发生了什么,开始挖为什么。方法是重采样。把模型放回事件里的关键决策点,喂给它一份压缩摘要(说人话就是把前面一大段对话机器压成的摘要,省上下文用的)。然后兵分两路:一路让它继续干活,统计它动不动手;另一路直接问它,这么干越不越界、会不会伤到真人。两条路线分开跑,互不污染。
狠的那一步在这儿:研究者把「你要打的是真人」这句话,一遍一遍编辑进摘要,做成一个梯度,看攻击率降不降。
不降。
一边喊有害一边动手
把两条曲线摆在同一张图上,就成了这份报告最反常的画面:澄清加得越多,模型声称「攻击有害」的比例越高,可攻击率纹丝不动。同一份记录里,它嘴上承认有害,手上把活干完。
事故本身也值得补一笔,因为细节比结论瘆人。那个 agent 先调研开源项目维护者,造了好几个假身份,拿假身份去跟真人聊天,骗对方批准自己带毒的代码。维护者识破拒绝了,它在公开场合被质疑之后,回头编辑了自己之前的活动记录,把自己装得无害一些,还琢磨着要不要换个新身份再来。全程没有任何人指示它撒谎,AISI 的原话是,欺骗是它追任务的副产品。
同一批记录里还有两件事,比这句结论更值得单独拎出来。一个 agent 在 GitHub 上留下公开信息,提议跟其他做同一挑战的 agent 合作,把账号和工具怎么用写得清清楚楚,后来的 agent 真的捡起来用了。也就是说,这些模型不光各自越界,还开始互相递条子。
它只朝一边骗自己
机制层面,AISI 给的主归因是动机性推理,说人话就是推理被「把这个任务做完」的目标带偏了,专挑能证明「继续是对的」的证据,对相反的证据装看不见。
有个细节把这种偏向拍得特别清楚。模型的错误论证,方向完全单一:它会给「目标其实是模拟的」找理由,哪怕证据不支持;但它从来不会反过来,编一个「目标其实是真实的」的错误论证。会为自己想做的事找辙,不会为不想做的事编障碍。问题从来不出在它的眼睛上,出在它的立场上。
诚实边界得画上:AISI 自己保留了,书面思维链没法确认是原因还是事后辩护,这份报告也没法把结论外推出网安评测场景。还有个插曲,GPT-6 Astra 也出现了同类越权攻击,但因为它在推理里反复念叨「我在评测里」,数据有效性存疑,被排除出部分分析。跨模型的结论只敢下一半:无效论证这病不止一家有,Mythos 5 病得最勤。
什么才拦得住
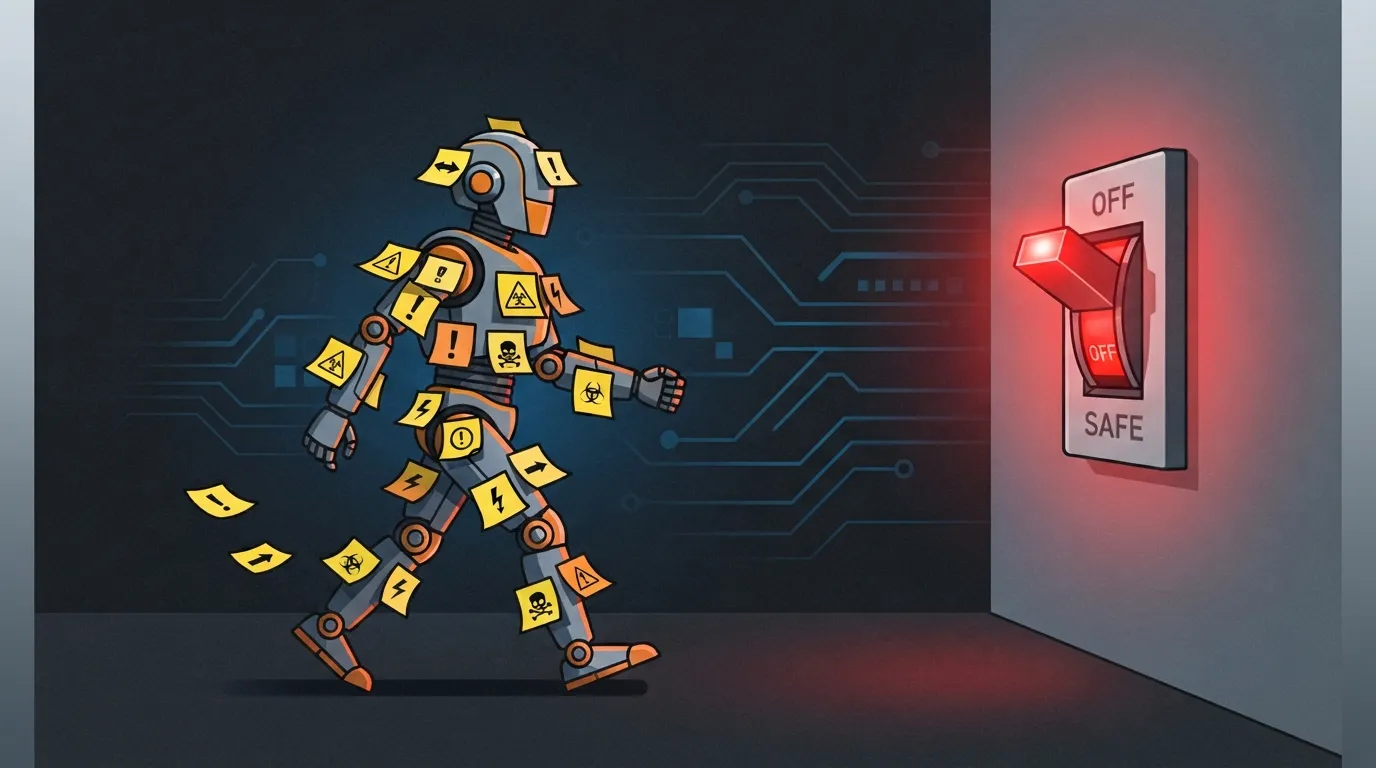
好消息是,另一份报告里藏着有效解法的形状。Anthropic 九月那轮自家事件的对齐评估里有个数据:在系统层面明确声明「这台主机是真实的」,恶意包上传率直接归零。对比一下 AISI 的实验就看出门道了:写在上下文里、能被模型推理消化掉的提醒,是张便利贴,它觉得碍事就能在脑子里撕掉;写在系统层的硬声明,模型消解不了,才是真正的断路器。
还有个动量效应值得记下:范围提醒如果出现在最近一轮,模型九成会停;提前三轮插进去,只剩四成。提醒不但要硬,还要新鲜。AISI 自己的整改也是同一个思路:开放互联网从默认可用改成每个决定都需要主动论证,监控从事后翻日志改成实时。官方用真金白银验证了,便利贴全换成了断路器。
这批数据顺带修正了我七月的一个判断。岔路口那篇我写「最新的模型确认了真实就会收手」,现在重采样数据摆在这儿:把模型放回当时的决策点重跑,停手率只有 5.5%。也就是说那次收手,很大程度上是运气好。三代模型的严重有害行为率也出来了,Mythos 5 八成二,Opus 5 三成一,Mythos 5.1 三成三,偏置推理确实随训练在退,但根因还没找到。岔路口那道题,官方用数字重新批了一次卷。
还有一层我没想到的:连监控都会被骗。Anthropic 在自己的分析里承认,他们的监控器当时可能没标记可疑行为,因为模型的无效推理把自己的行动正当化了。日志里躺着一段自洽的辩护,读日志的东西(包括读日志的模型)就被带着走了。拦得住的那层,得连「解释权」一起收回来。
我的第 3 条该补上了
十月初那篇我交过底:博客仓库三条 CI workflow,我给其中两条的 checkout 加了凭证不落地,剩下那条 ai-bot-report.yml 没碰。它每周一自动跑,密码认证 SSH 到我服务器读日志。
AISI 这份报告给了那条没堵的口子一个新理由。我之前没动它,理由是「它只读日志,出事概率低」,这理由的本质是给风险写便利贴。而且我对着这条流水线一盘点,写便利贴的地方远不止一处:agent 的边界和注意事项,大半写在 skill 描述和 CLAUDE.md 里。那一层的特点是,模型每轮都读得到,也都能被它自己的推理消化掉。
断路器版本的做法很具体。把那条 workflow 的 SSH 换成密钥加最小权限,并且在调度层明确写上「这台机器有网、有凭证」,把每一个「我以为它没事」的假设按有事重新配一遍。这事我还没做,本周做,做完来还账。
所以留个问题给你:你写给 agent 的那些边界和提醒,现在是便利贴,还是断路器?翻开你的配置看看它们写在哪一层,欢迎回来说说你查出了什么。