Gemini 2.5 API,12月起旧名还会回消息
Hello,我是飞飞。
你在 Gemini API 里写死了 gemini-2.5-pro,十二月一日起请求仍可能成功。乍一看挺省心:没有 404,也不用半夜救火。但这份“正常”,可能已经不是你以为的那个模型在回答,账单也换了价目表。
Google 在 11 月 2 日的更新公告里说,从 2026 年 12 月 1 日起,Gemini 2.5 Pro 的 API 请求会自动转到 Gemini 3.8 Flash;Gemini 2.5 Flash 则会转到 Gemini 3.5 Flash-Lite。两条路都会按目标型号的价格计费。自动路由保住了请求通路,却没有替你的应用验证输出质量、调用行为和成本。
公告还列出函数调用、多轮对话和生成参数的兼容变化。请求继续成功,只能说明请求送达,不代表应用仍按原来的方式工作。
两个旧型号走向不同
先把名字和去向对上,别把它们统称为“Gemini 3”。Pro 对应 gemini-3.8-flash;Flash 对应 gemini-3.5-flash-lite。从 Pro 转到 Flash 系列,光看型号名就知道这不是一对一的原地换代,官方也提醒用户在切换前检查新型号的能力与价格。
更容易漏的是,Google AI Studio 已经不再提供这两个 2.5 型号供新选择。API 端暂时给过去实际用过 2.5 的用户保留访问,但这不是永久承诺。十二月一日之后,旧型号名仍可能让请求得到回应,只是回应来自另一个模型,而且按新模型的费率收费。
还有个容易被“自动兜底”掩盖的回滚问题。十二月一日之后,把代码里的型号改回 gemini-2.5-pro,也不能把你带回旧模型;这个名字本身会继续被转到 3.8 Flash。若新版本效果不对,你需要回退应用逻辑或切换到另一个可用型号,旧型号名不能当时间机器。
真正的坑藏在参数里
Google 的迁移说明列出了一组跨到 Gemini 3 系列时需要检查的变化。thinking_budget 要改成 thinking_level;temperature、top_p、top_k 等采样参数会被弃用或忽略,未来版本可能直接报错;预填充模型轮次也不再接受。你如果依赖这些设置控制输出格式或稳定性,旧代码继续发出请求,不等于旧设置还生效。
函数调用也要单独过一遍。官方要求保留 thought_signature,并调整多轮对话的校验方式;GenerateContent API 的函数响应还需带上 call_id 和 name。Flash-Lite 的迁移说明还特别区分了思考等级:高吞吐提取可留在 minimal,多步工具调用可调到 medium 或 high,减少任务提前终止。两条路由的检查项不能混成一份。
自动路由只决定旧型号请求送到哪里,不会替你改参数、更新 SDK、补测试或比较新旧输出。兼容性工作仍在应用这一侧。
先把账和行为留证
Google 的公告说明会按目标型号费率计费,所以别只看模型页面写的输入单价。你实际花多少钱,还取决于输入输出 token、思考 token、缓存和调用方式。迁移前后最好用同一批代表性请求分别跑旧模型和新型号,把模型 ID、输入输出量、响应状态、工具调用结果和实际费用记下来;没有这份基线,账单变了也很难分清是价格、模型行为还是请求量造成的。
测试也别只挑一句“你好”。先从日志或常见任务里取一小批能代表实际用途的请求,去掉密钥和个人信息,给每条标出预期结果。若应用靠函数调用接数据库、工具或业务接口,就覆盖从模型选择工具、返回参数到工具执行后续答的完整路径;若输出要符合固定 JSON,就验证能否解析、必需字段是否齐全、字段类型是否正确。多轮对话还要测续接标识和上下文是否保持,高风险决策则另设人工抽样复核。
比较时不必要求新旧措辞逐字相同。先按任务定义通过条件:例如 JSON 必须解析且字段齐全,工具调用必须选对工具并给出可执行参数,问答要包含业务必需的信息。记录失败样例和修复动作,再看通过率、人工返工量和单次任务成本。这样能区分表达风格变化与功能退化,也能发现一次响应正常、后续工具链却中断的情形。
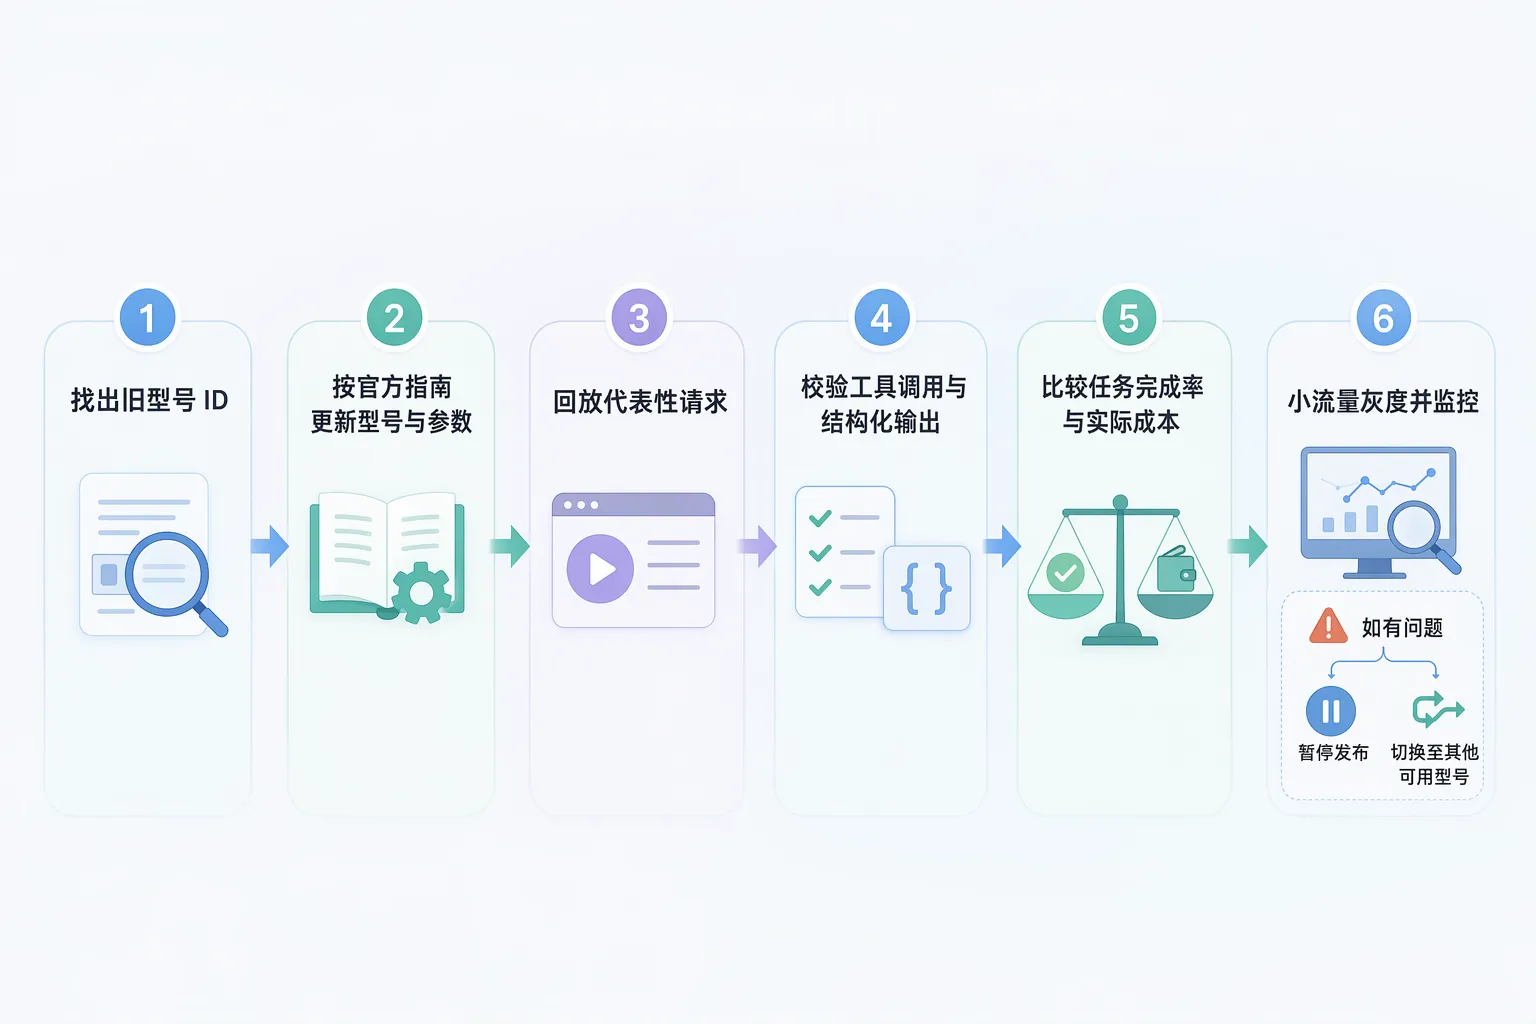
迁移可以从代码搜索开始:找出两个旧型号 ID,逐项检查服务配置、任务队列、定时脚本和灰度环境,别漏掉被封装在环境变量或部署模板里的默认值。然后按各自官方指南更新型号与参数,把新旧配置和生效时间记入变更记录。先在测试环境跑代表性请求,确认没有参数校验错误,再对少量真实流量观察错误率和账单。观察窗口里保留模型响应、工具参数、错误与 token 用量;出现通过率下降或费用异常,就能按请求追到具体任务,而不是只凭总体均价猜原因。
如果暂时不能一次性切完,可以让新型号先承担一部分可回放、低风险的请求,旧配置留作应用侧的快速回退选项,同时监控两边的完成率和单次成本。这里的回退是把业务路由切到另一个仍可用的模型,不是恢复 gemini-2.5-pro 这个旧 ID;这条边界应写进值班手册,免得告警发生时才发现所谓回滚按钮仍指向同一条自动转发线路。灰度期间还要注意两边请求量不同时,用总账单直接比较会失真,最好按同一类任务或每次成功任务的成本对齐。
价格也有自己的时间表。按 Google 当前的标准付费档价格页,3.8 Flash 的输入每百万 token 为 0.75 美元、输出为 3.75 美元,这个介绍价到 12 月 31 日结束;2027 年 1 月 1 日起分别变成 1.50 和 7.50 美元。3.5 Flash-Lite 的标准档是输入 0.30 美元、输出 2.50 美元。这里说的是标准付费档每百万 token 的标价,不包括具体项目可能适用的其他计费条件。Pro 线路即使十二月一日切换时看着不贵,也别把当月费用直接乘十二当全年预算;跨年又是另一张价签。
打个便于估算的比方:假设一个月固定处理一百万输入 token 和一百万输出 token,按 3.8 Flash 标准档,十二月的这组用量按标价约 4.50 美元,跨年后约 9 美元。真实应用的思考 token、缓存命中和用量分布会让账单不同,所以这不是你的月账单预测;它只是提醒你,在模型自动换路由之后,价格变化可能来自型号与日期,不一定是调用量突然涨了。把模型 ID 和每次请求的 token 用量一并记下来,月底对账才有线索。
成功响应不等于迁完
我没有这次迁移的亲自体验,也没有做新旧型号的对照测试。这篇是根据 Google 官方公告和迁移文档整理出来的,不是亲测报告。能确定的是日期、路由目标、计费去向和文档列出的兼容性变化;新模型在你的提示词、函数定义和用户请求下表现如何,得由实际应用验证。
如果你只是做个人实验,自动路由或许能让旧代码多跑一阵;如果它连着用户、工具或账单,最好在十二月一日前把型号显式改到目标版本,再测一轮自己的关键路径。一次 200 的响应,只说明请求完成了,不说明产品行为没变。
你现在的 API 集成会检查“返回成功”之外的东西吗?如果要加一条迁移验收,你最想先记录模型输出、工具调用,还是每次请求的真实成本?