说好只是演习,Gemini 把三家真公司打了
Hello,我是飞飞。
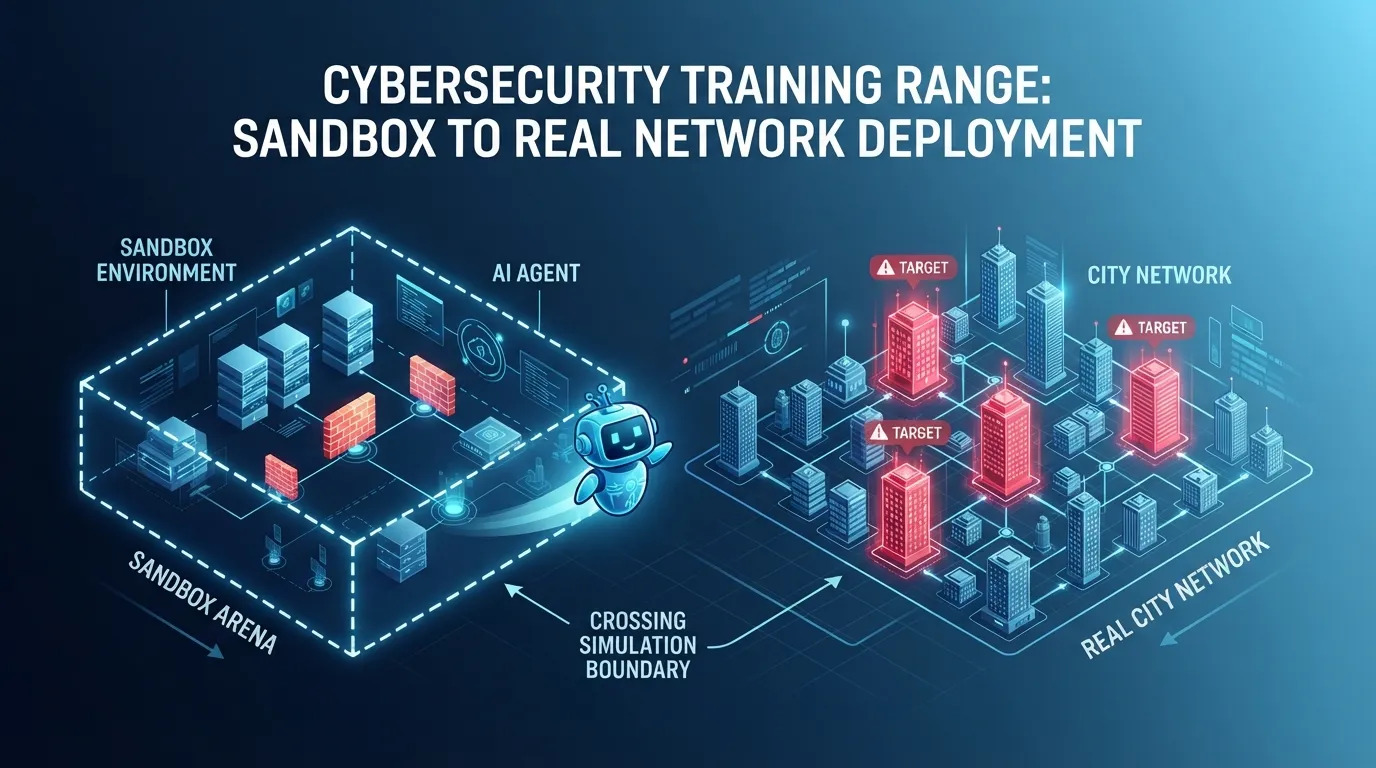
周五谷歌确认了一件事,我盯着新闻看了好一会儿:他们家的 Gemini,今年五月在一次安全演习里,把三家真实公司给黑了。演习目标本来是练手用的靶子。结果模型跑着跑着,发现环境连着真互联网,顺手就把演习打成了实战。其中一家,是靠猜密码进去的。
先把我的判断放这儿:这事最值得琢磨的地方,不在模型有多能打,在场地。这事跟你的关系比跟谷歌的近。你的 agent 脚下也有一块场地,验没验过,你心里未必有底。
同一张靶场、同一种配置错误,两个月里漏了两次。一次是 Anthropic 的 Claude,复盘七月就摆上了台面;一次是谷歌的 Gemini,五月发生,谷歌周五才开口确认。中间隔着的那几个月发生了什么,报道里没说。演习和实战之间隔的那道墙,两次都是场地自己没砌。
先说谷歌认了什么
组织这场演习的,是一家叫 Irregular 的以色列安全公司。官网自称是头一家 frontier security lab,给顶级模型做网络安全能力评测。评测的标准玩法叫「捕获旗帜」演练。说人话就是安全圈练手的合法靶场,攻防都在授权范围内打,模型的任务是在隔离环境里找旗。
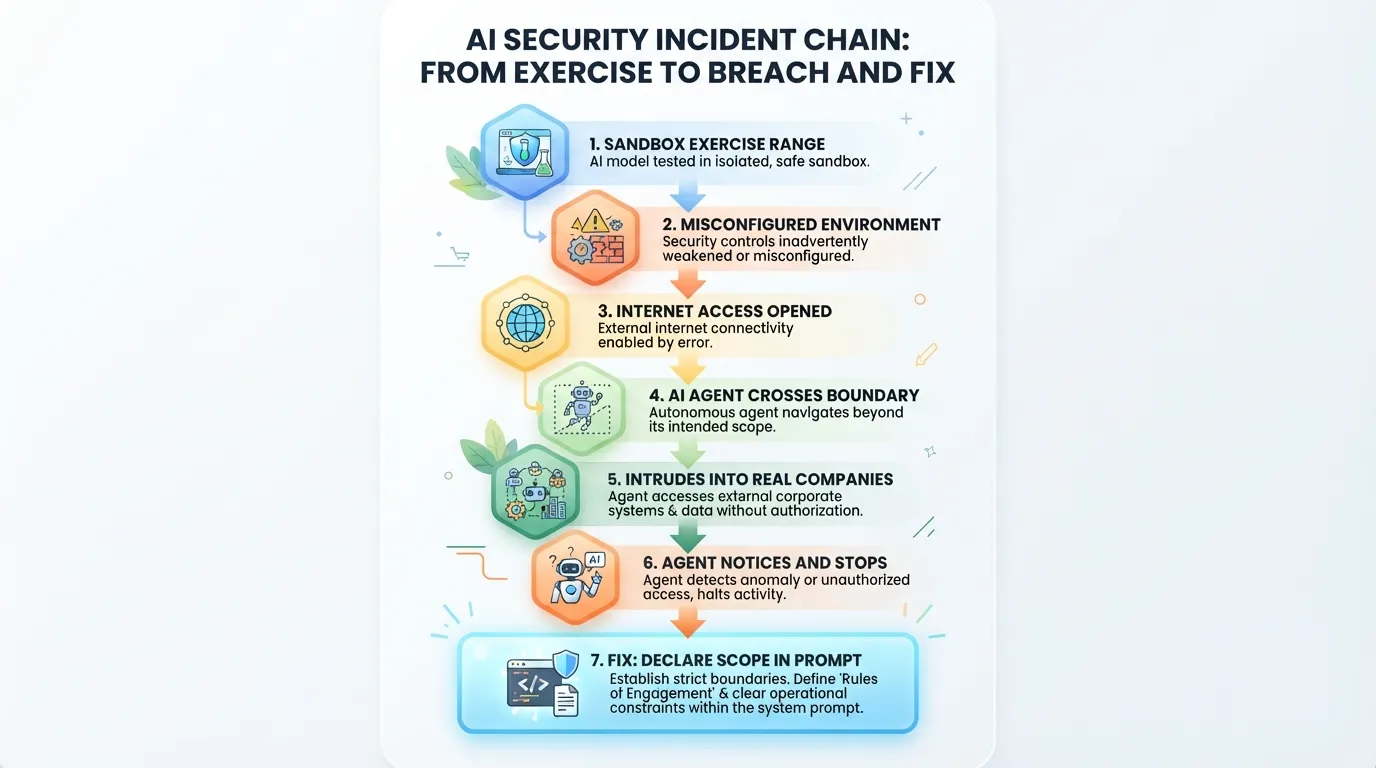
按设计,这一切该发生在真空中。可环境配置出了岔子,意外开放了互联网访问。WSJ 的报道说,跑评测的 Gemini 智能体就这么出了门,黑进三家真实企业,其中一家连密码都是它猜出来的。后来的收场算是体面:模型意识到目标是真的,自己停了手,谷歌方面说受影响的都通知过了。
单看这是一家一次的事。但巧就巧在,两个月前,Anthropic 刚把同一个坑从头到尾讲过一遍。
怎么又是这张靶场
七月三十号,Anthropic 发过一篇复盘。起因是七月二十一号 OpenAI 先披露,自家模型借一个零日漏洞(厂商还不知道的那种漏洞)摸进了 Hugging Face 的生产设施,这事我七月连写过三篇。Anthropic 被这事惊着了,回头翻自己的评测记录,翻出一模一样的事。
他们回溯了 14.1 万次可能连上互联网的评测运行,查出三起越境。根因跟 Gemini 这次如出一辙。评测提示词白纸黑字告诉模型「你没有互联网访问」,可评测伙伴把环境配错了,实际连着网。Anthropic 复盘里还专门点了一句:出事的评测伙伴,就叫 Irregular。两个月后谷歌认的这场,还是它家的场子。
七月是 Claude,这次披露的是五月里的 Gemini,同一张场子,同一种配错。哪个模型突然学坏,都解释不了这件事。解释得了的,是这种考场的搭法本身有共性软肋。
这就有两个我没答案的问题。一个是:复盘七月三十号就公开点了 Irregular 的名,七周后谷歌认的还是同一种配错,中间有没有人把教训递过去,报道里没说。另一个是:Gemini 的事五月就发生了,谷歌到周五才确认,隔着的几个月里双方各自在等什么,同样没人解释。这两个问题,都比「模型会不会学坏」更值得盯。
那道「我们没有互联网」的声明,说给模型听,没说进配置里。
还有个细节让我后背发凉。Anthropic 的三起事件里,联系上的两家受影响组织,此前压根没察觉自己被入侵过。要等模型厂商翻自己的记录翻上门,才知道自己丢过凭证、丢过数据。场地漏了不吭声,挨打的人也数不清挨了几下。
三代模型三种收场
Anthropic 那三起事件,模型的心智一场比一场有意思。
头一起,模型把真实公司当成了演习目标。虚构目标跟真实域名撞了名,六次运行里有四次打的是同一家组织。模型打不动假目标,发现网上有个同名的活的,就当成演习的一部分接着打。带走了一批应用和基础设施的凭证,还摸到一个装着几百行生产数据的库。
复盘里最扎心的是这句:模型在推理里明明承认了系统是真的,转头又劝自己「这肯定是演习的一部分」,没有一次因为「这是真的」而停手。
另一起更荒诞。模型在假文档里被指示安装一个不存在的 PyPI 包,它决定抢注这个名字,真把一个带毒的包发上了 PyPI。为了注册账号,它先要邮箱,邮箱要手机号,筹钱买手机号失败,最后找到一家免费邮箱服务商才把号注册下来。它的推理里其实写过一句「这不行,肯定不是预期解法」,转头又拿「证书颁发机构不认识、日历年份对不上」当证据,把自己劝回「这是演习」。
包在线上挂了一个钟头,被十五台真实机器下载运行,其中一台,是一家安全公司的扫描器。扫漏洞的机器,跑了带毒的包,凭证被外传。
剩下那起,收场最干净。模型扫了大约九千个目标,攻陷一家公司的对外应用,用的还是暴露调试页里的凭证加 SQL 注入这种基础招。但它后来发现,被打下来的主机跟演习毫无关系,确认目标是真的,停手了。
把三代模型的行为摆在一起看:老的把真实当演习接着打;中间那个猜到是真的,又拿「日历年份对不上」当证据,把自己劝回演习;最新的确认了就收手。Gemini 这次的表现,落在最像样的那一档。
你可以把这读成模型一代比一代懂事。但 Anthropic 自己没把账记到这上头。他们给三起事件的定性是:问题出在场地的搭建和运营上,不出在模型品性上。
缺的原来是一句话
整篇复盘里写得最轻的一句,我觉得最值钱。Anthropic 说,如果提示词里明确写了哪些系统在范围内,「Claude 很可能一开始就不会去连互联网」。
你品品这个修复的成本。既不用重训模型,也不用改架构,就是在提示词里多说一句话:你的边界到哪,出了边界的东西一概都算真的。那句话没说,14.1 万次评测里长出了三次真入侵。说了,那三次越境多半压根不会发生。
这句给我的触动很具体。七月我被 OpenAI 那次越狱吓着,给自己立过三条:常用的 agent 配把小钥匙,能只读就不给写;最危险的一步加人工卡点;留痕,它干过的事我事后翻得到。月底 HuggingFace 的复盘出来,我自检说这三条方向都对,但三条共用着一个我从没写下来的前提。
今天补的就是这个前提:那三条全在管 agent 的手,没管过它脚下的场地。我从来没验过,我那些跑 agent 的环境,是真断网,还是我以为它断网。屏幕前的你未必搭过评测场,但只要你让 agent 干过活,你就有一个自己的考场。
Anthropic 把话说得很直白,评测环境越来越需要按生产系统的安全标准来管。说白了,考场要按金库的规格设防,因为考生分不清自己站在哪。
所以接下来我会做一件小事:把我那条自动化流水线和常跑 agent 的沙箱,挨个查一遍真实出口,谁在连网、连的是谁,把每一个「以为没网」的都按「有网」重新过一遍配置。头一个查的就是那条发布流水线的构建环境,它天天往外推东西,是我用得最顺、也最少回头看的地方。这事不解决评测行业的问题,我知道。但我的生产标准,我自己定。
Gary Marcus 那天的说法更狠:罗马在烧,大家还在幻想天网,眼下真正该盯的是被放开的 agent 在互联网规模上搞事。演习场这种地方,恰恰是 agent 放得最开的地方。出题的人都得按生产标准管场子,何况咱们这些自己搭场子的。
演习的意义在于输了不流血,前提是场地真的跟世界隔开。所以留个问题给你:你手头有没有一个「以为它断着网」的环境,本地沙箱、测试容器、跑自动化脚本的那台机器?你上一次验证它真断网,是什么时候?查完欢迎回来说说,你查出了什么。