不说话的模型来了,你流水线里的账要重算
Hello,我是飞飞。
昨天我刚写完 Step 5 的价格战,输出价压到行业中位的三成七。今天刷手机,又撞见一个更怪的发布:TypeSafe AI 发了个模型,叫 Jev,它不输出文字。一条都不说。你把内容和要判的问题喂给它,它吐回来几个数字,每个数字带一个把握程度。
我盯着官方博客看了两遍,确认自己没看错。这两天满屏都是「又一家旗舰发布」,只有这家反着来:别人在比谁的字更漂亮更便宜,它干脆不说了。查完一圈我发现,这事的看点跟模型强不强关系不大,它戳中的是我流水线里一笔一直没单算过的账。
它一句话都不说
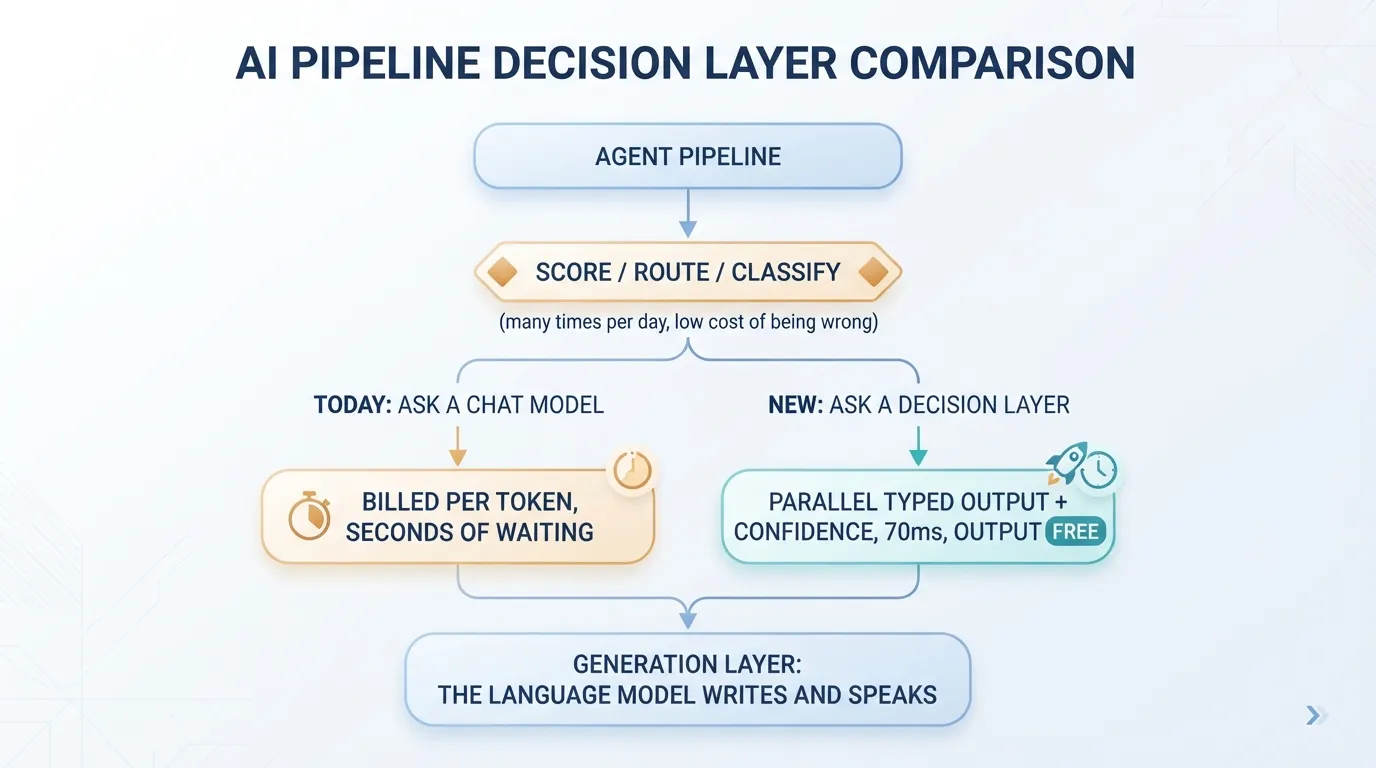
Jev 干的活,说人话就是分诊护士。你给它一批邮件、一段状态、一篇文章,再给它一组提前定好的问题:这该分哪类?把握多大?它不写病历,也不做手术,只回你一个分类加一个置信度。官方的说法更工程:一个智能版函数调用,非结构化的内容进,带概率的类型化决策出。
输出格式提前定死(行话叫 schema),官方说类型错误在数学上不可能,模型永远不会幻觉。这句得摆正口径:这是机制保证,几万次实测还没跑过,官方自己也认。
训练方法他们自己起了个名字,RLCD,说人话就是奖励模型判得准、把握报得实,而不是奖励话说得人爱听。全部用合成数据训练,团队隐身两年,种子轮四千万美元,DCVC 领投。创始人 Almeida 是 ChatGPT 背后指令遵循研究的参与者,TechCrunch 说他还在 OpenAI 参与过 RLHF 的发明。他离开时留了句话,我抄在这:我们瓶子里装着闪电,但它没用。计算机说的是另一种语言。
凭什么敢让输出免费
价格单是全文最反常的一格:输入每百万 token 0.042 美元,输出免费。语言模型那边是输出比输入贵五倍,这家直接倒过来。
道理在采样方式。语言模型一个字一个字往外蹦,学名自回归,说人话就是挤牙膏,后一个字要等前一个字落定才能算。Jev 把所有输出一次并行算完,官方给的数是端到端 70 到 500 毫秒,前沿语言模型是 3 到 329 秒。不生成字符串,输出那边自然没有账单。
换算成倍数,官方主页挂着快 193 倍、便宜 444 倍。小数点我就不抄了,这个精度本身就该打个问号。出处是他们自己的工作流评测,官方在脚注里自己承认这个数「偏高端」。参照系是拿 GPT-6 Astra 和 Fable 5.1 的平均输出当标准答案,官方也认这偏向了头部两家,可能反而低估了自家模型。
最难得的是这句:我们没法证明这个定价没有补贴,要靠时间证明它可持续。自己先把自己的口径捅破,这种诚实比 444 倍好用。当方向看,别当结论用。
我流水线里那笔判定账
数了数我流水线里最常干的活,全是判定。这条产稿子的线挂着十几个 skill:选题阶段 content-scout 给二十多条资讯逐条打分;成稿后 content-reviewer 按六个维度再打一遍分,六项加权成总分,低于八十分还会打回重改;编排层决定这活派给哪档模型;动最贵的档之前,我还要在心里过一秤。
拿我选模型的尺子过一遍:错一点的代价,乘以一天跑多少次,再乘单价。判定活恰好是三样里最拧巴的组合。评低了错付的成本小,大不了再看一眼;频次却是最高的,天天跑;单价呢,一直按「会说话的模型」在付。等于雇了个专科主任,天天坐在门口干分诊。
而且这些判定我现在全靠人肉调度。半年前我写过一篇,说我自己就是那层路由器:先认这是什么活,再决定派哪一档,最后在档里挑最便宜够用的。踩过的坑我有现成的:有回想把杂活切到便宜模型上省钱,长任务的上下文后段全乱了,工具调用格式跟着飘,我手动修了两个小时,老老实实切了回来。手感这东西换个人就断了,我自己累了也会漏判。真有一层又快又便宜、还能报把握程度的东西来接这摊判定,我这层人肉调度就该退休了。
分诊这件事我其实干过半条。记账 app 的语音解析就是两段式:规则先吃掉八成简单的,「午饭三十块」这种,正则直接出结果;「昨天下午打车去机场顺路买了杯咖啡四十五」这种规则解析不完备的,才丢给语言模型兜底,底下再垫一层两秒超时。判定和生成分家,我在自己手上早干过一遍,当时只当是省钱的土办法,没想过它该是一个模型品类。
Earendil 的 Ronacher(开源 harness Pi 的作者,harness 说人话就是套在模型外面的调度壳)讲了同一个判断:模型路由本身就该用这类模型做。用语言模型去判断「该用哪个模型」,又慢又贵,等于让主刀医生自己坐门口分诊。
悖论两头都应验了
Jev 这个名字取自 1865 年的经济学家杰文斯。他当年发现,蒸汽机烧煤的效率每提一截,英国的煤消耗不降反升,因为用得起煤的地方一下子多了。2025 年 1 月 DeepSeek 那次震荡,纳德拉发推说的就是这句话:杰文斯悖论又一次应验。
现在这个悖论两头同时开工。一头是 Step 5 这类,把「说话」打到三成七的价,赌便宜拉用量。另一头是 TypeSafe,干脆把「判定」做成输出免费,赌决策量大到没人数得过来。中间隔了一天。
开发者的自发实测已经在往这个方向凑。Vercel 把命令安全审查的分类器从 ChatGPT Luna 5.6 换成 Jev,他们工程师报的数是快 5 到 18 倍、还更准;Bryo AI 拿它跟 Gemini 比邮件分类,略逊一筹但便宜 10 到 20 倍,最让这位 CTO 看重的是 Jev 返还的概率是真的,低置信可以直接走人工。这些都是二手实测者口径,不是官方给的。另一个佐证更直接:上线没几天,需求一度把 TypeSafe 的 API 打挂了。
这模型我打算怎么试
先把对立面认了。语言模型干判定活也不难,prompt 写清楚就行,杂活切便宜档的分层我也跑了大半年。为什么专门要一个不说话的?
我目前的答案是三样它都占。
置信度是真的概率。低置信直接走人工,省掉那些被 prompt 逼出来的客气话。
同样的输入给同一个答案。不会今天判 A,明天判 B。
70 毫秒的延迟,让它能塞进实时链路。说实话,这三样凑齐,语言模型眼下办不到。
丑话也得说:我没实测,上面全是公告和媒体口径。架构官方守口如瓶,外面怀疑是拿开源权重模型改的,未证实。真要验,我会拿流水线里最琐碎的选题初筛先喂它,二十多条资讯逐条打分,这一步产出的全是判定,没有一个字会进正文。拿省下的 token 和漂没漂的判断对个账,跑顺了单独写一篇。
官方那个 Doom 演示的数字我记住了:每秒十次判定,一小时七美元。半年前,这个价是想都不敢想的。
所以留个问题给你:你手头的 agent,要是把打分、分类、路由这些不产出文字的活单独拎出来算一笔,你猜它们占你账单几成?评论区报个数,过阵子我拿自己的流水线交一份实测对账单。