44 分挤进开源前三,这回只用了 6000 亿参数
Hello,我是飞飞。
今天刷到阶跃星辰的发布,我先愣了一下:Artificial Analysis 的智能指数榜上,开源权重模型的前三名是 45 分的 GLM-5.3、44 分的 Kimi K3。现在榜上多了个 44 分的 Step 5 Preview,跟 K3 同分。查了下参数,K3 是 2.8 万亿,这位只用了 6000 亿。
同样的分数,参数差了四倍多。你看到 27B 激活这个数,多半会冒出跟我一样的念头:那我家那台机器,是不是也能跑个「缩水版」?先说答案:跑不动。为什么,后头拆。这事比「又一家发了旗舰」有意思多了。
先把话撇清:上周我刚写过把腾讯 770B 接进 Claude Code,那篇的重心是「怎么接、接入后账单怎么算」。今天这篇不写接入,Step 5 的权重 10 月 15 日才放,现在想接也没得接。这篇算的是另一笔账:跑到同一档分数,参数和钱的账。
还有一个反常值得记一笔:阶跃跳过了 Step 4.x,直接从 3 跳到 5。官方没解释为什么,报道猜是架构换血、当代际跃迁做,不是小步迭代。是不是真的,得等技术报告,但至少说明这家把 Step 5 当一次重新下注,而不是例行升级。
价格表先到了
Step 5 Preview 今天 API 全量开放,model id 叫 step-5-preview,权重反倒要等 25 天。这个顺序跟 K3 那次正好反过来:K3 是权重先开、托管慢慢来;阶跃是先把生意做了,开源权本当期货。
价目表:输入每百万 token 1 美元,输出 2.7 美元。对比一下行业里位数,输入 1.88 美元、输出 10 美元。输出价是中位数的两成七。想试的话门槛也低,起步套餐 49 元,对应约 400 元额度,没设 5 小时限额。
官方喊的「单任务成本只有 Opus 5 的八分之一」,这个口径我得摆正:这是官方说法,没给统计方法,按哪个任务集、含不含折扣、怎么摊的固定成本,都不知道。当方向看,不当结论用。
会不会用,我的账是分层的。每天让 agent 干活前先掂量值不值得动用最贵那档,杂活切便宜模型省额度,这个动作我重复了几个月,肌肉记忆都有了。Step 5 这个价位要是站稳,它抢的其实是「杂活档」的位置,那个位置现在坐着 770B 和 DeepSeek。
同分低价替代品一多,最贵那档就得回答一个问题:凭什么贵三倍?答不上来,溢价就守不住。所以阶跃不等你问,价格表先到了。
6000 亿对 2.8 万亿
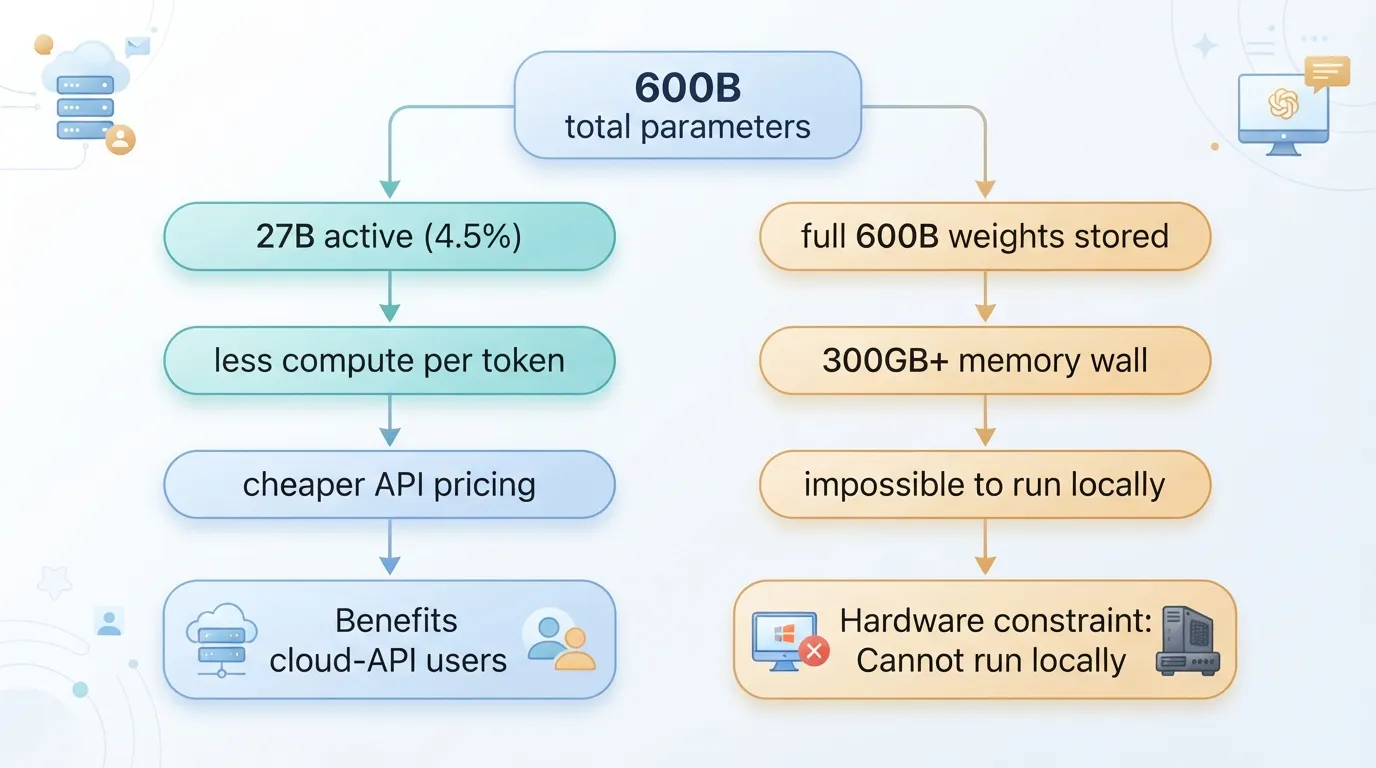
答案写在架构里:稀疏 MoE,总参 600B,激活 27B。说人话就是每次推理只动用 4.5% 的参数。
这个数字容易让人想岔,我第一眼也想岔了:27B 激活,是不是意味着我家里那台机器也能跑个「缩水版」?想明白后发现这是个要拆的误解。
MoE 的稀疏,稀的是计算,不是存储。打个比方:600B 是图书馆的全部馆藏,27B 是你一次借阅的量。借得少是真的,但书架得把整个馆藏都放下。600B 权重就算压到 4bit,也得 300GB 往上。上个月 K3 那 594G 的箱子我搬不动,这个月换成 6000 亿,还是搬不动,堵门的是同一堵墙。
那激活小图什么?图的是账单。每个 token 的计算量小了,推理服务商的单位成本就低,价格才有得降。所以 27B 激活真正的受益人是 API 用户,获益方式是便宜,获益前提是你别惦记本地跑。
速度这份账也在同一张表上:每秒 100 token,行业平均 65。跑 agent 的人等模型吐字,每一秒都算在成本里。
再把整张榜摆开。开源这头三把交椅:GLM-5.3 用 7400 多亿拿 45 分,K3 用 2.8 万亿和 Step 5 用 6000 亿拿 44。闭源那头,Claude Fable 5.1 和 GPT-6 Astra 都在 53 分。开源和闭源之间还隔着 9 分,这 9 分是所有国产开源旗舰共同的下一道题。
Step 5 这次的看点在别处。它没去堆参数硬追,转头把「每分分数摊多少参数」这个新轴立了起来。同样一档分,它的身板最小。
还有个反差点。官方管这套打法叫「帕累托前沿」,说人话就是在智能和成本这条曲线上,占一个别人没占的点。堆算力的故事讲了好几年,开源阵营开始换故事了:从「我多强」,换成「同样的强,我多便宜」。
哪些分能信,哪些再看看
跑分这块,我的尺子分三档,可信度从高到低。
AA 智能指数 44 分,第三方榜单,我自己去官网核对过 GLM-5.3 和 K3 的分数,对得上。这一档可以信,Step 5 确实站在了开源第一梯队。Terminal-Bench 4.0 拿 33.3%,高于 DeepSeek V4.1 Flash 的 26.8% 和 K3 的 12.6%,这个口径是报道转的,先记下。K3 只有 12.6% 跟我印象里它的编程能力有反差,等权重开了我自己跑过再下结论。
自建基准那档就要多留个心眼了。阶跃自家的 StepCodeBench,553 个仓库、33 种语言,听着很唬人,专项成绩只有一句「仅次于 GPT-6 Astra 或 Claude Opus 5」,具体分数没给。自家出题自家考还不公布卷面分,当宣传看就好。
这里替厂商说句公道话:自建榜的动机我能理解。AA 这类综合榜量的是平均能力,真实工作里的长尾场景,比如 CLI 工具链的调用、金融文档的解析,综合榜根本测不到,厂商只能自己出题。Kimi、DeepSeek 都干过同样的事。问题不在自建,在不给分。卷子出了,分数捂着,读者就只剩一句形容词可领。
我真想看到的那格是空的
说个真心话。价目表上我最想盯的一格,缓存价,这次没看到。
跑 agent 的都懂为什么。Claude Code 每一轮都要把系统提示、CLAUDE.md、十几个 skill 的描述原样重发一遍,缓存命中率直接决定账单。这事我有切身数字:我发现 CLAUDE.md 的每一行每一轮都在当 prefix 重发,命中率只有三成,一个月账单干到 106 美元。把它从 12KB 砍到 4KB,命中率拉到七成三,账单落回 33 美元。便宜模型能不能用,半条命在缓存价上。上篇写 770B 的时候,缓存每百万 0.042 美元那格是我最眼前一亮的。这回阶跃的价目里没见着这格,是没配还是没公布,得等它权重开了我去问。
10 月 15 日见
我自己的算盘:API 我今天不打算充钱跑长测。Preview 阶段的表现,各家报道都提了一句「有待更多用户验证」,我不急着当那个验证的。8 月写过 Qwen 27B 自测分超 Opus 的教训还热乎着:全是自测数据的东西,等第三方和实测对齐了再算数。
但 10 月 15 日这个日子我记下了。权重一开,两件事可以做。
头一件,接进 Claude Code 换底座跑两天,看看工具调用飘不飘。这活儿的深浅我踩过,我那条写文章的流水线挂着十几个 skill,每个都照着 Claude 的脾气磨过。上回给 770B 做接入,工具调用格式十有八九会飘,得挨个重校。
另一件,把 600B 的权重体积跟 K3 那 594G 摆一起掂量掂量,看看这堵墙有没有松动的迹象。到时候成不成,我另写一篇交代。
至于换不换引擎,我的账前面已经摊过了:便宜模型顶得了「活」,顶不了「底座」。十几个 skill 的迁移成本摆在那,没有同分还便宜三倍以上的确定性,我不会为省那点 token 钱把底座搬来搬去。但这话只对我这种重底座用户成立。你要是纯 API 跑长任务、没什么历史包袱,输出价打三折,值得今天就试。
开源前三的牌桌这下有意思了:7400 亿坐一把交椅,2.8 万亿坐一把,6000 亿也挤进来坐了一把。下次谁再发旗舰,比的恐怕就不只是分数了,是谁用更小的身板拿到同样的分,再把价格表压得更狠。所以留个问题给你:你手头正在花钱跑的那个模型,如果有个同分的三折价替代品出现,你会当场切过去,还是先等它跑三个月口碑?