照着参数挑模型的,这回挑反了
Hello,我是飞飞。
4 月 25 日那篇 MiMo-V2.5-Pro 实测的结尾,我留过一句话:「等下一代 V3 或者 V2.6 出来,我再跑一次对照。」今天 V2.6 来了。
不过今天先翻出两笔旧账:一笔是我两天前没查到的那个空格,一笔是 4 月欠下的那次对照。你跑 agent 的时候,每跑完一个任务,第一眼看的是什么?我承认我看的是这一轮烧掉多少钱。
所以我 9 月 20 日写阶跃 Step 5 Preview 那篇,最惦记价目表上缓存输入那一格。它当时空着,我的原话是「是没配还是没公布,得等它权重开了我去问」。
48 小时之后,同类那一格有数了,不过填表的是另一家公司。小米自己标的价目表上,MiMo 的缓存输入是每百万 token 0.0036 美元,不到输入价的百分之一。权重也是当天挂出来的,MIT 许可。至于 Step 5 那一格,还空着。
真正让我坐住的是分数和价钱摆在一起的样子。MiMo-V2.6-Pro 在 Artificial Analysis 的智能指数上是 46.32 分,每任务成本 0.13 美元。我两天前写的那位是 44 分、每任务约 0.72 美元,分数它高 2.3 分,账单只有五分之一。而它的总参数是 1.02 万亿,比 Step 5 那 600B 大了七成。
两天前我给 Step 5 下的判词是「同样一档分,它的身板最小」。今天这位身板更大,账单反而更小。这个反差把我 9 月 20 日那句「便宜模型顶得了活,顶不了底座」也一并摊上了桌面。
先把同一张表摆开
最扎眼的一组是跟 Grok 4.7 摆在一起:46.32 分对 46.45 分,差 0.13 分;每任务 0.13 美元对 3.74 美元,差 28.8 倍。
开源这把椅子上原来坐着 GLM-5.3,44.78 分、每任务 2.01 美元,MiMo 比它高 1.54 分,还便宜 15.5 倍。Kimi K3 那边是 43.59 分、2.00 美元,价差差不多。往上看天花板,Claude Opus 5 的 50.78 分还在上面,价签也跟着在上面,5.86 美元,贵 45 倍。
口径得说清:「开源第一」的完整意思是开放权重模型里的最高分。它上头还压着闭源那几家,比如 Claude Opus 5,50.78 分,人家没开放权重。这个限定省不得。
4 月我写过一句,说公开测试和各家的内部测试之间那道分差,已经大到让「开源第一」这种官方表述越来越不够用了。当时是抛给读者的问题,今天算有了半张答案。
这张表好就好在,46.32 和 0.13 出自同一套第三方算法。前几篇我核厂商自报分数核到嫌啰嗦的那部分,这次能省掉。
还有一个倍数得留个心。财新转述的口径是「为海外同等智能模型价格 1/20 至 1/60」,那说的是单价;AA 的 28.8 倍说的是每任务成本。两个数不是一个算法,不能拿去互相比。我只引后者,因为前者我核不到算法。
我省下来的是额度
这里得先拆一层:上面那些都是 API 按量计费的口径,我自己主力走的是 Claude Max 订阅,不按 token 付钱。同一张价目表,落到你头上是什么,得看你怎么付钱。
所以「便宜十五倍」这件事落到我头上,兑现不到月费上。它兑现成额度:一天能多跑多少活。
我拿 API 跑过一条写文章的流水线,命中率只有三成,一个月账单干到 106 美元。钱是漏在缓存上的:CLAUDE.md 里每一行都当提示前缀重发一遍,而那文件里塞着会变的字段,前缀哈希一变,整段缓存全废。
改法不玄。会变的那几个字段挪出 CLAUDE.md,写进当轮消息;常驻的 skill 每次都显式加载一遍;系统提示词里别塞时间戳。做完再把 CLAUDE.md 从 12KB 砍到 4KB,命中率到 73%,账单落回 33 美元。那笔是 API 口径,跟我订阅的月费不是一回事。
所以你如果也走订阅,别指望换过来月费会变少。变多的是能跑的活。
如果你手上没有历史包袱、纯拿 API 跑长任务,那是另一笔账:输出价只有 Step 5 的三成左右,今天就能试。
身板大了,账单小了
规格先摆一下。总参 1.02 万亿,激活 42B,384 个专家每次叫醒 8 个,60 层滑窗加 10 层全局注意力,1M 上下文,原生全模态。
行话叫稀疏 MoE,说人话就是每次推理只动用 4% 出头的参数。
本地这条路我劝你先别惦记。稀疏稀的是计算,不是存储,这话我 9 月 20 日讲过一遍:600B 压到 4bit 也得 300GB 往上。现在总参到了万亿,照同一个粗口径换算,体积从 300G 出头变成 510G 上下。
那便宜从哪来。先看单价,Pro 每百万 token 输入 ¥3、输出 ¥6,折合 0.43 和 0.87 美元;Step 5 是输入 1 美元、输出 2.7 美元。输入砍了一半多,输出只剩三成。
单价管的是每公里多少钱,AA 那个 0.13 管的是整趟车费。两笔数分开看才清楚:剩下那截差价出在里程上,同一个任务它烧掉的 token 更少。
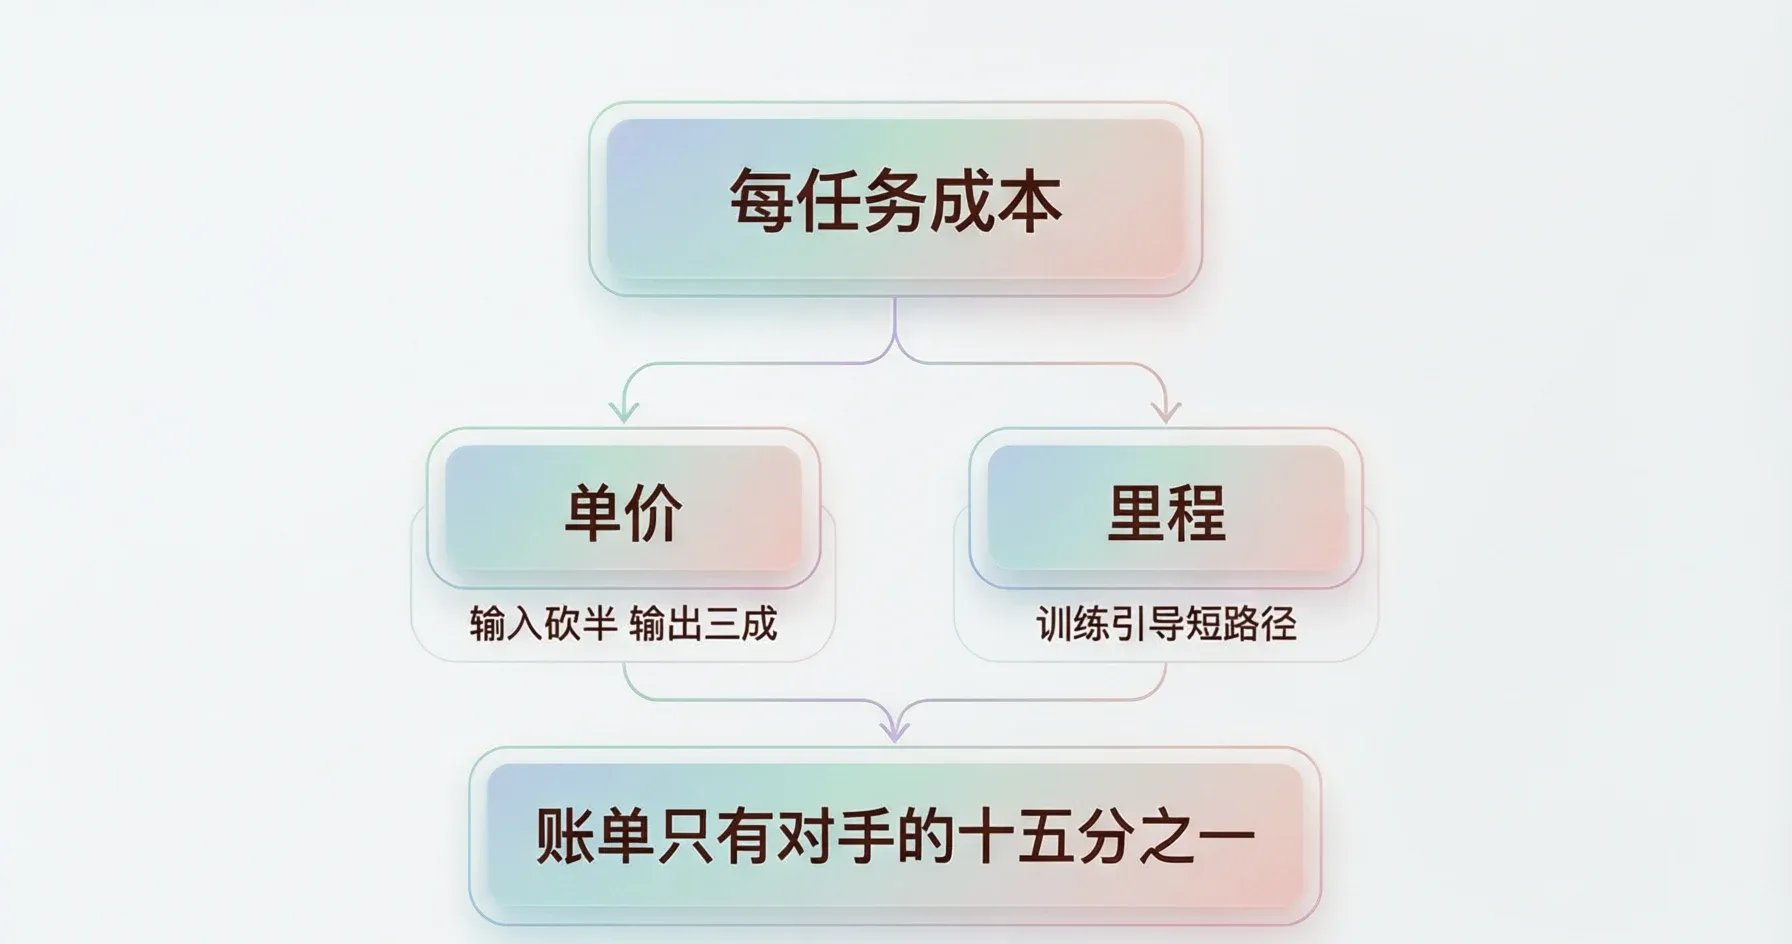
官方模型卡把这件事写进了训练目标,叫 Groupwise Advantage Redistribution。它在线给跑通的轨迹排序,把模型往更短的路径、更少的 token 上引。
这套训练的排场也不小。一次混合 RL 覆盖写代码、通用 agent、视觉、安全四个域,官方管它叫 You Only RL Once。官方说这么练出来的策略能迁移到没见过的工具壳上。异步 GRPO 那边,每一步 1,568 条提示,每条提示都采 16 遍。官方给这次发布的定调是「探索 RSI 路径的关键一步」。RSI 是递归自我改进,让模型参与打磨下一代自己。这个调门值不值得认,要等权重真跑起来才有答案。这套训练目标里最实在的一条就是 GAR:它直接解释了那 0.13 是怎么来的。
这条线我不是第一次碰。4 月我拿 RSS 子 feed 那个任务自己数过 V2.5-Pro 的 token 消耗,大概省 30%,不到官方宣称的 42%。那次样本小,方向对得上。今天小米把「往短路径、少 token 引导」写成了明面上的训练目标。等于把我那次小实验追认了一遍。
自测表里输掉的那几格
46.32 是加权综合分,分科看它有明确的缺口。而且缺口是小米自己在模型卡里列出来的,不用别人挖。
终端里连着跑长任务那一项,它 34.9 分,Claude Opus 5 有 49.0,GPT-5.6 Sol 有 39.9。代码工程那一项,它的 26.5 分对 Opus 5 的 37.0。缺口最大的是安全渗透,它 47.9 分,Opus 5 是 70.0,GPT-5.6 Sol 到了 78.5。
这三类正好是我日常最常跑的活:终端里长跑、重构,还有安全那一类。总分站上了第一梯队,能力分布明显偏科。
翻过去的地方也有。自动化那项它 53.1 分,压过 Opus 5 的 50.3;通用岗位任务那项 62.0 分,GPT-5.6 Sol 只有 45.4。
还有一笔旧账顺带结掉。4 月我盯着一件事:「36 天一代会不会再压到 18 天」。另外还有个担心,这个速度会不会以牺牲测评真实度为代价。
结果一等五个月,节奏没往上冲,慢下来了。倒过头看,这五个月换来的是实打实的换代:拿换代前后的两个数比,DeepSWE v1.1 这项从 19.0 跳到 71.9,终端长任务这项从 1.5 到 34.9。我 4 月那个担心,落在了放心的一侧。
这张对比表是小米自己出的,竞品那一列也是小米自己跑的。当参考可以,当结论不行。4 月我写过一句:「不回避这些负面反馈,是我判断一个模型能不能长期用的底线。」今天这批数照同一个规矩摆。
门槛过线了,然后呢
9 月 20 日我给自己立过一条线。原话是「没有同分还便宜三倍以上的确定性,我不会为省那点 token 钱把底座搬来搬去」。今天这条线被越过去了。我当初设的是三倍,现在摆在面前的是十五倍,分数还更高。
说真的,越线归越线,我不打算今天就搬。权重刚挂出来,我连装都还没装,这篇摆的是账,还没走到体感那一步。
更堵心的是它的弱项正好压在我最重的场景上,终端长任务那个 34.9 我天天要碰。剩下那道坎不在模型身上,在我那条挂十几个 skill 的流水线。每个 skill 都照着 Claude 的脾气磨过,迁移成本跟分数和价钱无关。
所以「便宜模型顶得了活,顶不了底座」这句,今天得拆开看。活的那半句它够格了,底座那半句,要等我跑完才算数。两天前说那句话时我心里是稳的,今天它松了一半。
这次不用等权重了
4 月许的那个对照,今天到期了。跟 4 月不同的是,这次不用再等。V2.5-Pro 那次官方说的是「将全球开源」,公测期先放 API。我从 4 月一直等到最后,也没等到一个能下载的权重。这次是当天就挂在 Hugging Face 上,MIT。
对照我打算这么跑。接进我那套 Claude Code 流水线换底座,跑两天,把十几个 skill 挨个重校一遍。重点盯终端里的长任务,顺手把 token 消耗记下来,跟 4 月那 30% 对一遍。4 月我写「等下一代我再跑一次对照」,今天轮到我自己兑现。跑出来是什么数,我照实说。
回到标题那句话。参数表上,MiMo 的总参比 Step 5 大了七成,按「身板越小越省」这个直觉,它该更贵。账单恰好反着来:决定你月账单的是单价乘上里程,身板得排在这两样后面。
所以你挑模型的时候,先看总榜排名,还是先翻自己最常跑的那几类活的分项?我这两天被这张表提醒了一遍:总榜好看,不等于你日常那几类活好用。