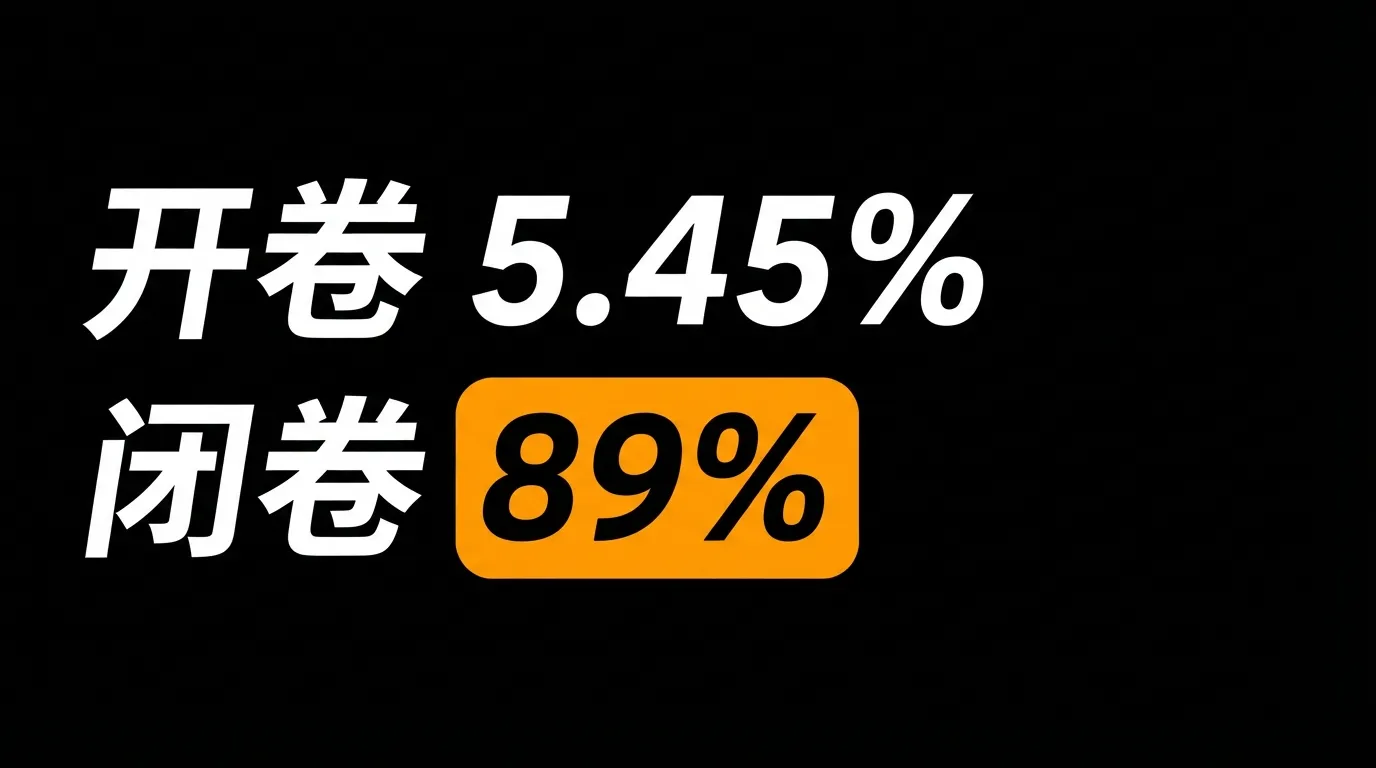
开卷 5.45%,闭卷 89%:先看分母
Hello,我是飞飞。
11 月 4 号我写过一句:这些数字都是腾讯自己报的,我照抄,不替它背书。它点得准不准,要等权重放出来,等第三方在真机上跑一遍才算数。
昨天第三方跑了。Artificial Analysis 给 Hy4 的 AA-Omniscience 打出五成准确率,89% 的幻觉率。同一个榜上,Kimi K3.1 Pro 的幻觉率是 37%。
5.45% 对 89%,差了十六倍。你要是在群里刷到这张对比图,第一反应大概是:翻车了。可这两个数其实不在一个考场,除出来的十六倍不作数。
我第一反应也是。然后我去翻腾讯自己的发布材料,翻到一半停住了。腾讯给了两套数。
先说我等到了什么
AA 这次给的不是一个孤零零的总分。
Intelligence Index v5 上,Hy4 拿 35 分。中国实验室里排第二,比 Kimi K3.1 Pro 的 46 分低 11 分。跟 Grok 4.7 的 xhigh 档打平。
这个指数是九项评测平均出来的,里面有终端任务、私有编码题、极难知识题、科研题,还有我们这篇要聊的那个知识幻觉榜。
我 11 月 4 号等的就是这种数。厂商自报是它挑过的卷子,第三方把所有卷子一起摆出来。
这里还得补一句尺子的事。AA 十月底刚换过版,六成题目换成私题,或者不公开答案的留出题。换完之后,开源和头部闭源的差距从 3 分扩到了 12 分。这个我 10 月 29 号那篇写过,不重复。只是提醒你,35 分要放在换过版的秤上看。
腾讯自己给了两套数
这是我这篇真正想说的。不是第三方打脸,是腾讯家里两套数。
混元官网的研究页写:自建测试里,幻觉率从 preview 的 15.76% 降到 5.45%。
腾讯官网的中文新闻稿写:自建测试里,幻觉率从 Preview 版的 12.95% 降到 7.2%。
两处都叫自建测试,都不是第三方。都带着同一句「猜测导致的错误率从 23.1% 降至 5.6%」。
媒体转载也分成两拨。财联社、21 财经和澎湃用的是 12.95% 那一套,凤凰网和腾讯新闻的另一篇用的是 15.76% 那一套。
我没法判断哪个是最终口径,腾讯没说。按 7.2% 那一套算,跟 5.45% 差了将近两个百分点。这是同一个版本、同一个指标,不是四舍五入能解释掉的差。
我能确认的是:同一个指标,同一家公司,两套数,两边的定义都没写全。
不过有一条线索。腾讯云 ADP 的博客把 15.76% 到 5.45% 这一组,称作「混元专项搜索测试中的幻觉率」。按这个说法,5.45% 是搜索专项里的子集,另一组可能是范围更宽的自建测试。这是我的推断,腾讯没把两个测试集写出来。
这件事比 89% 更值得记。89% 只说明它闭卷答题会硬编。两套数说明的是另一件事:这个指标在发布材料里还没被固定成一个能复现的东西。你今天引用哪一套,全看你碰巧点开哪个页面。
厂商自报里还有一处,毛病差不多。金融众测那 579 个任务,Hy4 拿 3.04 分。第二名 DeepSeek V4.1 Flash 是 2.97,差 0.07 分。官方口径是「位居开源模型第一」。这个第一只在这四款参测模型、这一批任务里成立。0.07 分的差距有多薄,它就有多薄。
所以你看,限定词有没有跟着数字一起走,比数字本身更要紧。
两个数不在一个考场
说到这,得把开头那个十六倍讲清楚。
腾讯那个 5.45%,完整的话要长得多。自建测试,加上针对时效检索、多源信息整合、事实一致性校验的专项搜索优化。在这个前提下,幻觉率从 preview 的 15.76% 降到 5.45%。开卷,题目自己出,场景是带检索的问答。
AA 那个 89%,是 6000 道短事实题,覆盖 6 个领域 42 个主题。不给上下文,不给工具,闭卷直接问。
一个开着卷考,一个合着卷考。把这两个分摆在一起比高低,等于拿开卷考的分去笑话闭卷考的人。
更关键是分母。AA 的算法是错答除以(错答 + 部分答对 + 没尝试)。说白了,分母只算没答对的那部分。
所以 89% 的正确读法是:Hy4 闭卷答对了大约一半。没答对的那一半里,89% 是硬编的错答案,剩下约一成是回答不完整,或者干脆没尝试。
按五成准确率往下算,错答占了全部题的 45% 左右。留给「不知道」的空间只剩 5% 上下,而这 5% 里还混着答了一半的。
这个读法比「89% 的题都答错」难听得多,也准确得多。前一句是耸动,后一句才是它的病。
89% 到底差在哪
说实话,不能相减,不等于 89% 没问题。
同一把尺子上,Kimi K3.1 Pro 是 37%。Hy4 的准确率还比 Kimi 高 1 个百分点,说明它答对的题不少。毛病集中在「不会就说不会」这一步。
对天天把 agent 放出去干活的人来说,这个代价很直接:它错的时候不会停,会递给你一个看起来很像答案的答案。
我 11 月 4 号写 Hy4 那篇时最看重的就是幻觉率,理由也是这个。跑分决定它能干多少活,幻觉率决定这些活里有多少要你回头重做。5.45% 那个数,当时让我觉得它能被放到没人看着的地方跑。89% 这个数,把这件事往后推了。
有些数只在分项里
35 分是个平均数,能把九件事抹平成一件。分项才看得出它强在哪、弱在哪。
FrontierCode 2.0 它拿 31%,比 Claude Fable 5.1 的 max 档低 1 分,比 DeepSeek V4.1 Flash 的 28%、Kimi 的 25% 都高。在这个编码专项上,它离头部只差一个点。
HLE-Diamond 那 33%,比 Kimi 的 37% 低。这一项考极难知识题,它还没进第一梯队。
AA 还给了两个数,几乎没人转。
一个是评测期间它输出了 1.6 亿个 token,中位数是 7260 万。话多了一倍多,啰嗦度在 68 个模型里排第 64。
另一个是第一个 token 的等待时间:103 秒。中位数是 16 秒。
这两个数也一样,得带着参照看。1.6 亿对的是中位数 7260 万,103 秒对的是 16 秒。裸数没用。话多直接进账单,首字慢直接进体感。一个模型在跑分上只差几分,在你的循环里每次多等一分半,这件事榜上不会写。
我为什么还没实测
有人会问,你天天写这些,怎么不自己跑一遍。
因为权重还没放出来。腾讯说的是「计划开源模型权重」,眼下只有服务和 API。腾讯还说,权重放出来的时候,模型系统卡片一起发,里面会有更全面的安全评估。我要等的是这两样。
我 11 月 4 号说过等权重放出来在自己机器上验,这句话我还没兑现。
API 现在能用,我没用,原因很普通:最近在赶自己的写作流水线,手头没有非它不可的活。拿它跑一个 hello world 不算实测,写出来也是凑数。
所以这篇到这里仍然是资料解读。每个数都对过出处,但它的一个任务我没跑过。等权重放出来,我拿手上现有的活跑一轮,再回来交账。
看到幻觉率先问三件事
这次的事收成三个问题。下次你看到「某模型幻觉率 X%」,先别转发,先问:
第一,什么题集。厂商自建的,公开的,还是买了私题的。
第二,开卷还是闭卷。带检索、带工具、带上下文,和不带,是两个能力。
第三,分母是谁。是全部题,还是没答对的那部分,拒答算不算进去。
三个问题问完,你会发现很多能吵起来的分歧,其实是尺子不一样。
尺子对上之后还敢比的那部分,才是真差距。Hy4 的 89% 对 Kimi 的 37%,就是这部分。
至于腾讯那两套数,我打算盯着。等权重放出来,等系统卡片一起发出来,看它最后认哪一个。
换个角度看,这次我学到的东西,跟 Hy4 强不强关系不大。是同一家公司能在一个指标上给出两套数,而且都不算说谎。两边都留了「自建测试」这个口子,口子留着,数就永远能挑。
你上一次因为一个跑分决定换模型,是什么时候?后来那个数,跟你的实际体感对上了吗?