AI 只接干完能判对错的活,你手上能剩几样
Hello,我是飞飞。
先问你件事:你手上那堆活,哪几样你敢整段丢给 AI,哪几样必须自己再过一遍?你大概能报出几个名字,但未必说得清那条线到底画在哪。
Anthropic 昨天发了一份报告,把这条线量出来了。他们用隐私保护的办法,看了 207,049 个科研会话。时间是 8 月 2 号到 9 月 30 号,全是消费版套餐。其中 128,914 个来自 Claude,78,135 个来自 Claude Code。
结论先说:AI 接走的活,几乎都有一个共同点,干完很快知道好不好。判不出、或者等不起的,它还没接走。
最值钱的那项只有 4.2%
报告里最扎眼的,是一组对不上的数。
528 名科学家填了问卷,让他们把 100 分拆到四类科研活上。构思与假设生成拿 35.6 分,排第一。数据收集 23.6 分,第二。数据分析和写作分别是 23.3 和 17.5。
再看这四类活实际用了多少 Claude。构思与假设生成只占 4.2% 的会话,Claude Code 上更少,2.1%。数据收集 11.5%。反过来,问卷里只值 17.5 分的写作,占了 32.0%。
觉得最重要的那项,用量垫底。
这不是科学家舍不得。换个问法就清楚了。问构思这块用不用 AI,17% 说完全不用,53% 说只让它打打下手,24% 说人机分担。问数据分析,44% 说人机分担,28% 已经委托出去。
差别就在这一层。构思停在打下手和分担,一步都没走到委托。数据分析走到了。
报告作者给了一句解释,说数据收集一大半得动手,构思不用。这句话解释了数据收集,没解释构思。
分界线到底画在哪
他们给每个任务打了一个分,叫「理论 AI 能力」。打分的办法有点朴素:让一个模型两两比,这两步里 AI 更擅长哪个?再用 Bradley–Terry 模型把胜负汇总成分数。国际象棋那个 Elo 排名,用的就是同一套模型。
分数出来以后,他们算了一个比值。这类活在 Claude 会话里占多少,除以它占研究者时间的多少。排在最后 20% 的任务,比值只有 0.2,Claude 基本不碰。中间那截大约 1,用多少跟花的时间成正比。最高的 20%,Claude 是 2.1,Claude Code 上更狠,3.9。
接着他们去找这个分数跟什么有关。最有解释力的是「适不适合强化学习」,相关系数 0.78。往下是认知类工作,0.69。反向的三个更值得记:要动手的 −0.57,要跟人打交道的 −0.31,监管卡得紧的 −0.38。
报告原话是,scientists appear to use AI where it works best。科学家看起来是在 AI 最管用的地方用它。
真正决定一件活会不会被交出去的,在它干完能不能很快知道好不好。强化学习吃的就是训练信号。结果来得快、样本又多,它就能反复试错,被优化。能被优化,模型在这件事上才会越来越强。测试过没过、代码跑不跑、统计检验的 p 值对不对,这些是机器判,一分钟出结果。文章顺不顺,你自己扫一眼也知道。构思好不好、这个方向值不值得做,没人能一键判分。
三个多月前我写过一条体感。agent 在机器能判死的闭环里,回溯能力是真的。到了判不死的开放研究里,零进展。那篇是我自己撞出来的。六天、几千美元,两篇论文的评语是 unambiguously rejected,明确拒绝,没留余地。今天这份报告,等于给那条体感配了一把能读数的尺子。
我拿它量了自己的流水线
我这条内容流水线有八个阶段,底下挂着十几个 skill:调研、写稿、润色、评阅、训练、配图、分发、发布。拿这把尺子回头量,结果是三层。
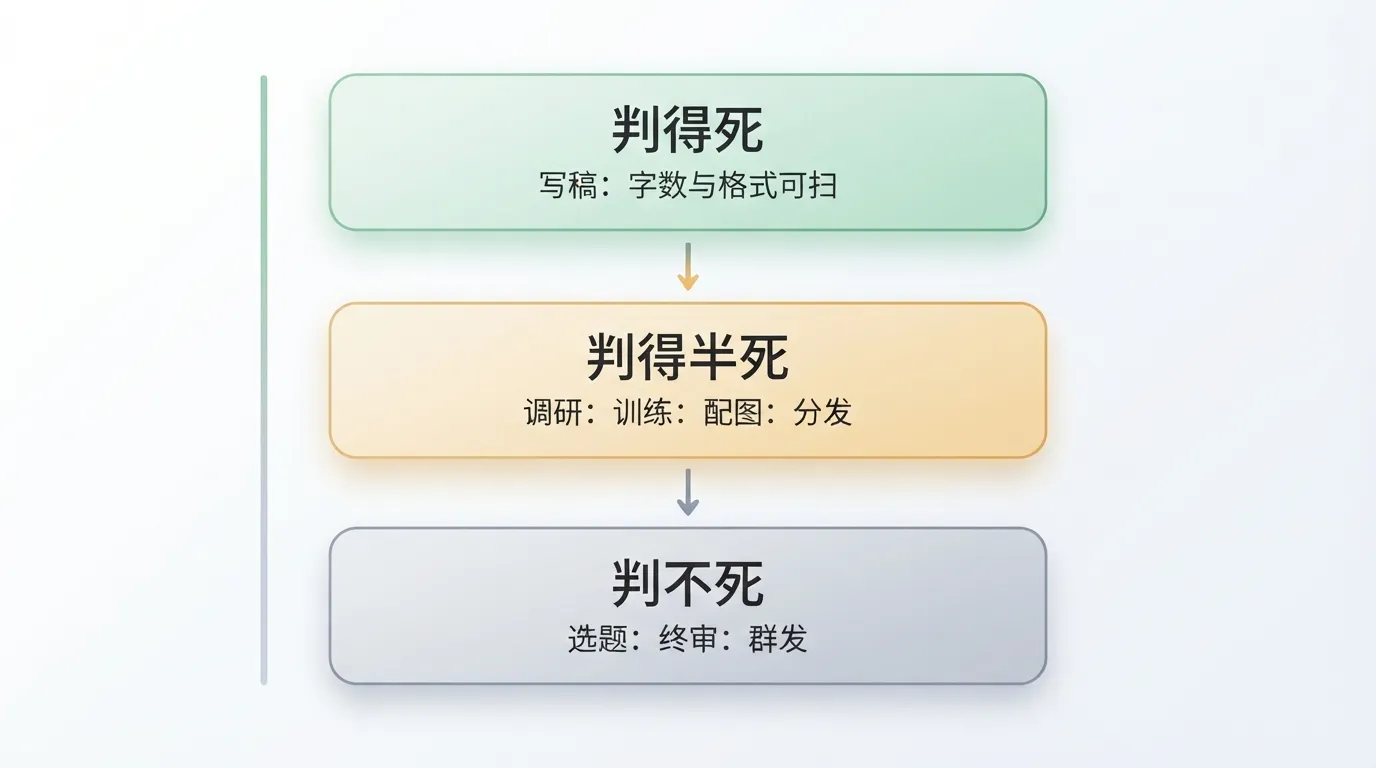
字数判得死。一个脚本数正文里的中文字符,不够两千就打回,多一个少一个都藏不住。破折号判得死,grep 扫一遍,命中一个删一个。对仗和三联否定也判得死,同样是 grep。规则书里写着,「不是 X 是 Y」这种句式全篇上限一次。连小标题有没有超过十二个字、有没有混进括号,都有命令能数。
这些我一律交出去,交得很放心。
半死的也有。调研,信源在不在能查,这个源值不值得读判不了。训练,规则有没有生效能扫,这条教训值不值得写进规则书判不了。配图,尺寸格式能查,这张图配不配得上这段文案判不了。分发,格式字数能卡,平台读者吃不吃这套判不了。
真正判不死的只剩三处:选题、终审、群发。今天写哪件事,没有脚本能给我打分。稿子最后能不能发,也判不死。评阅那一步能给我一个 85 分、89 分,但那只是个分数,不是判词。按不按发布键还在我手里。
我甚至写过一句话。真正管用的都是硬规矩。像「写得有人味」这种软要求,模型根本接不住。当时是在讲规则该怎么写。现在回头看,那句话讲的是同一件事。
最典型的是发布。它能推到草稿箱,但那个点群发的动作我故意没让它做。因为群发一天只有一次,推出去撤不回来。这一步的判据不是「对不对」,是「后果扛不扛得住」,机器给不出这个判断。
免得你以为我多有先见之明。这不是我一开始就这么分工的,我是被坑一个个推着走的。配图那个 skill 早期没把规则写死。agent 自作主张往正文里塞图床链接,还漏图。我才回去把那几条抠死。同一个坑踩到第三次,才想起来该把教训记下来。所以今天拿这把尺子量自己,量出来的是个事后形状。当初没画过这张图。
16 倍封顶,卡住的是账单
再往上一层是加速。他们做了三个情景,作者反复强调这些是 illustrative scenarios, not forecasts,是示意不是预测。
情景一,现有能力被广泛采纳。AI 能接走研究者 27% 到 52% 的时间,中位 38%。换算成产出,提速 1.35 倍到 2.02 倍。
情景二,75% 的非物理步骤自动化。计算机科学约 8 倍,统计约 7 倍,经济学约 6 倍,实验科学和医学 2 到 3 倍。
情景三,非物理步骤全部自动化。统计、计算机、经济、数学、心理这一批到 15 到 16 倍,生物、化学、材料、农业、生物医学只有 3 到 4 倍。
卡在后一档的那些学科,卡的是动手。报告算过:农业、生物医学、化学、材料的物理工作占研究者时间 38% 到 41%,中位学科只有 4%。
那为什么高到 16 倍就停住?报告算了笔细账。AI 一小时 30 美元,研究者一小时 95 美元。但 AI 每替你省下一小时,自己只跑 0.2 小时。省一小时花 6 美元,对 95 美元,差不多一比十六。全自动化了,成本还在那儿,加速也就到那儿。报告原话是,halving the cost of AI would double the rate of progress,AI 成本砍一半,进展速度翻一倍。
这句我读了两遍。因为我自己的账上真动过这一格。去年冬天我把 CLAUDE.md 从 12KB 砍到 4KB,砍掉的全是早就用不上的旧规矩。改完缓存命中率从三成跳到七成三,那个月的账单从 106 美元变成 33 美元。
我当时以为省下的是钱。按这份报告的说法,省下的其实是速度。
这份报告自己说了局限
这份报告不是一块铁板。
漏洞先出在方法上。能力分、时间占比、任务标签,三样全是语言模型分类器给的。只经 Anthropic 自己验证过。第三方解读里有一句说得很准:这些数还没有外部研究者复现过。那把尺子的刻度,是 Anthropic 自己刻的。
样本也有问题。528 名受访者主要来自美国和加拿大,集中在生命科学和健康科学。而且他们是从申请 Anthropic 科研资助的人里招的,本身就是重度用户。报告自己承认,这批人不代表全体科学家。
还有一处是构思可能被低估。很多构思嵌在别的任务里。比如跟 AI 讨论数据时顺手想到一个方向,分类器未必认得出来。这一点要紧,因为全文最扎眼的那个 4.2% 正是它。所以「最值钱的只有 4.2%」得按「可能被低估」来读,不能当精确读数。
还有一件事,报告列进了讨论但没给答案。产出变多,会不会压垮验证的速度。
我不打算替它补一个答案。这份报告最值钱的,是它给了一个能用的问法。
回到开头。你手上哪些活敢整段交出去?
现在有个更短的判据。别问这活难不难,也别问模型聪不聪明。问一句:这活干完,能不能很快知道干得好不好。
能,它已经在被接走了,而且接它的成本还在往下走。不能,它就还留在你手里,因为没人能快速判出好坏,不是因为 AI 不够强。
这个判据可以反过来用。你想知道自己那摊活会被吃到什么程度?先数一数,里面有几成是干完能快速判出好坏的。数得出来,心里就有数了。
Anthropic 说这是他们经济指数系列里的一环。这种量法后面还会再跑,等下一版出来,我回来对一遍。
那剩下一个问题给你。你手上最不敢撒手的那件活,是它干不好,还是它干完了你没法判断干得好不好?评论区聊聊。